 Readiz
토스는 AI 모델의 응답 시간을 어떻게 지킬까
TTS 지연을 줄인 자체 엔진에서 KV 라우팅, 과부하 제어, 커널 패치와 배포 자동화까지. 토스의 AI 서빙이 서비스 응답 시간을 지키는 구조를 살펴본다.
글 관리 · 공개 범위AI 모델을 서비스에 붙이는 순간, 모델의 성능표에 없던 문제가 시작된다. 전화 상담은 답변 내용이 좋아도 한참 뒤에 말을 시작하면 어색하고, 검색은 요청이 몰릴 때마다 느려지면 사용하기 어렵다. 토스의 서빙 엔지니어링은 이 응답 시간을 지키기 위해 GPU 선택부터 요청 배분, 엔진 내부, 배포 절차까지 하나로 묶는다.
정택현 엔지니어의 SlashLive 발표에서 흥미로운 점은 최적화를 다루는 범위다. 라우터 설정을 바꾸는 것으로 해결되면 거기서 끝내고, 특정 모델의 실행 경로가 문제라면 커널을 고친다. 기존 엔진으로 요구사항을 맞출 수 없을 때는 엔진 자체도 교체한다. 이렇게 얻은 선택지를 설정과 테스트로 남겨 다음 모델에도 반복해서 쓸 수 있게 한다. 빠르게 한 번 띄우는 능력이, 많은 사용자의 응답 시간을 계속 지키는 능력으로 이어지는 구조다.
토스의 성능 수치는 2026년 10월 14일 발표에 제시된 해당 구성의 측정값이다.
서비스의 응답 시간을 먼저 정한다
전화 상담을 생각하면 기준이 선명해진다. 사용자의 말을 텍스트로 바꾸는 STT, 답변을 만드는 LLM, 답변을 음성으로 바꾸는 TTS가 연결된다. 한 단계가 빨라도 앞뒤 단계에서 기다리면 사용자가 듣는 첫 응답은 늦어진다. 발표에서 제시한 상담 응답 목표는 700ms 이내였다. 사용자의 발화를 처리하고 답변 음성이 나오기까지의 지연을 관리하는 기준이다.
TTS에는 두 가지 시간을 따로 둔다. **RTF(Real-Time Factor)**는 생성에 걸린 시간을 생성된 음성의 재생 길이로 나눈 값이다. 예를 들어 10초짜리 음성을 3초에 만들면 0.3이다. 재생 속도를 따라가려면 1보다 작아야 한다. **TTFA(Time to First Audio)**는 요청 후 첫 오디오가 나올 때까지 걸린 시간이다. 총 생성 속도가 빨라도 첫 조각이 늦게 나오면 통화 상대는 기다려야 한다.
토스가 이 사례에 설정한 TTS 목표는 RTF 1.0 미만, TTFA 140ms 미만이었다. 여기에 요청량을 늘려도 같은 기준을 만족해야 한다는 조건이 붙는다. 한 사람과 통화할 때의 성공을 많은 사람이 동시에 사용하는 서비스까지 이어가야 하기 때문이다.
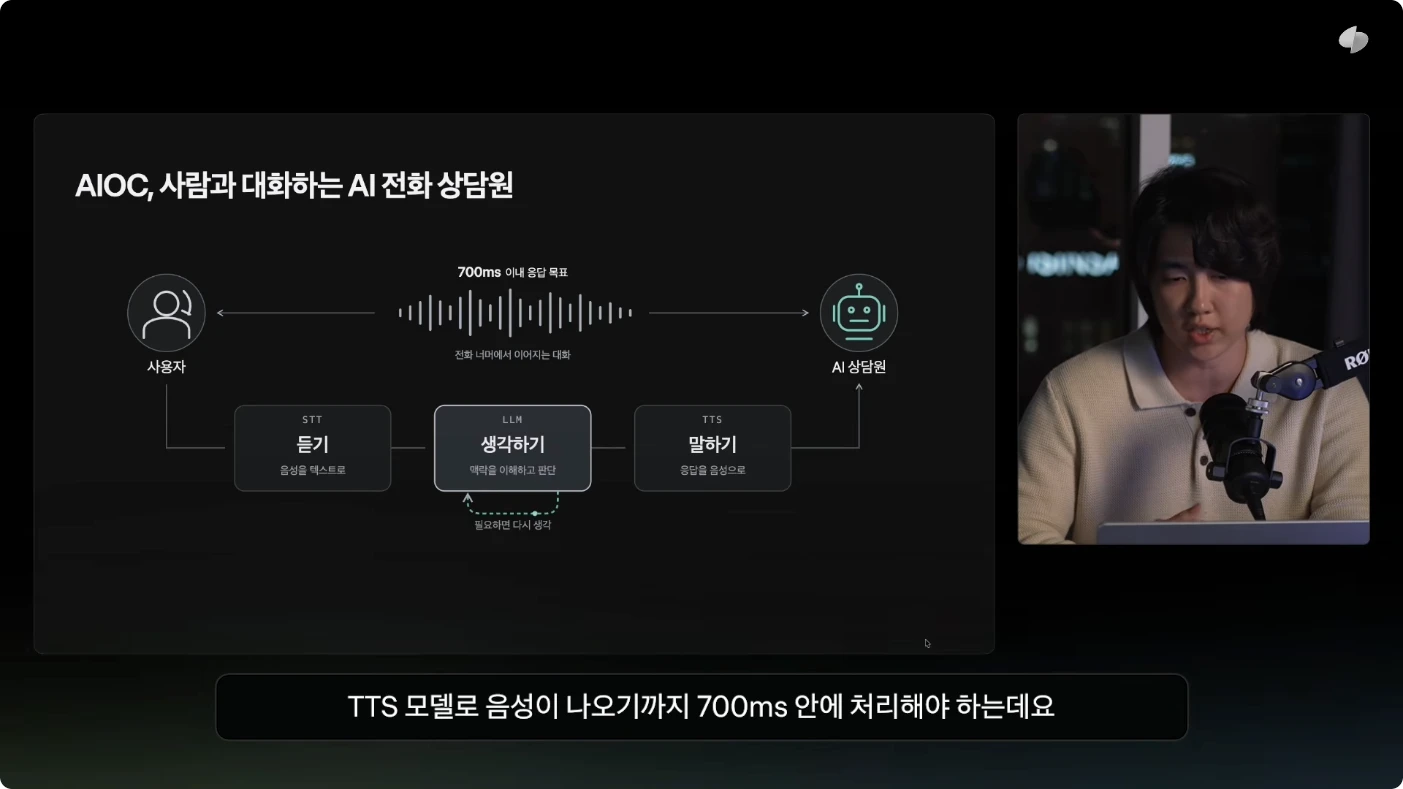
음성 인식에서 답변 생성과 음성 출력으로 이어지는 상담 응답 경로. 토스 챌린저스, 3:38
이런 조건이 있어야 GPU와 엔진을 고르는 기준도 생긴다. 최고 사양 GPU를 먼저 정해 놓고 모델을 올리는 순서보다, 목표 응답 시간과 처리량을 정한 뒤 그 조건을 만족하는 구성을 찾는 순서가 자연스럽다.
GPU와 엔진 선택을 설정으로 남긴다
토스는 모델 요청이 들어오면 필요한 GPU 수와 비용, ROI를 시뮬레이션한다. Blackwell, Hopper, Ada Lovelace, Ampere 등 보유한 장비 중 어디에 올릴지, vLLM이나 SGLang 같은 엔진 중 무엇을 쓸지 정한다. 엔진 버전도 선택지다. 검증된 안정 버전을 기본으로 두되, 필요한 기능에 따라 사전 릴리스나 특정 PR의 변경을 이어 쓰기도 한다.
전처리와 후처리, 자체 커널과 코드 패치, speculative decoding, Dynamo의 라우터와 분리 서빙 구성까지 같은 흐름에 들어간다. 이 선택을 모델마다 새 코드로 흩어 놓으면, 무엇을 바꿨는지 추적하기 어렵고 다음 배포가 다시 수작업이 된다. 발표에서 강조한 config-driven 방식은 이런 결정을 설정으로 표현하고, 선택한 조합을 시뮬레이션과 검증, 배포로 이어 주는 방식이다.
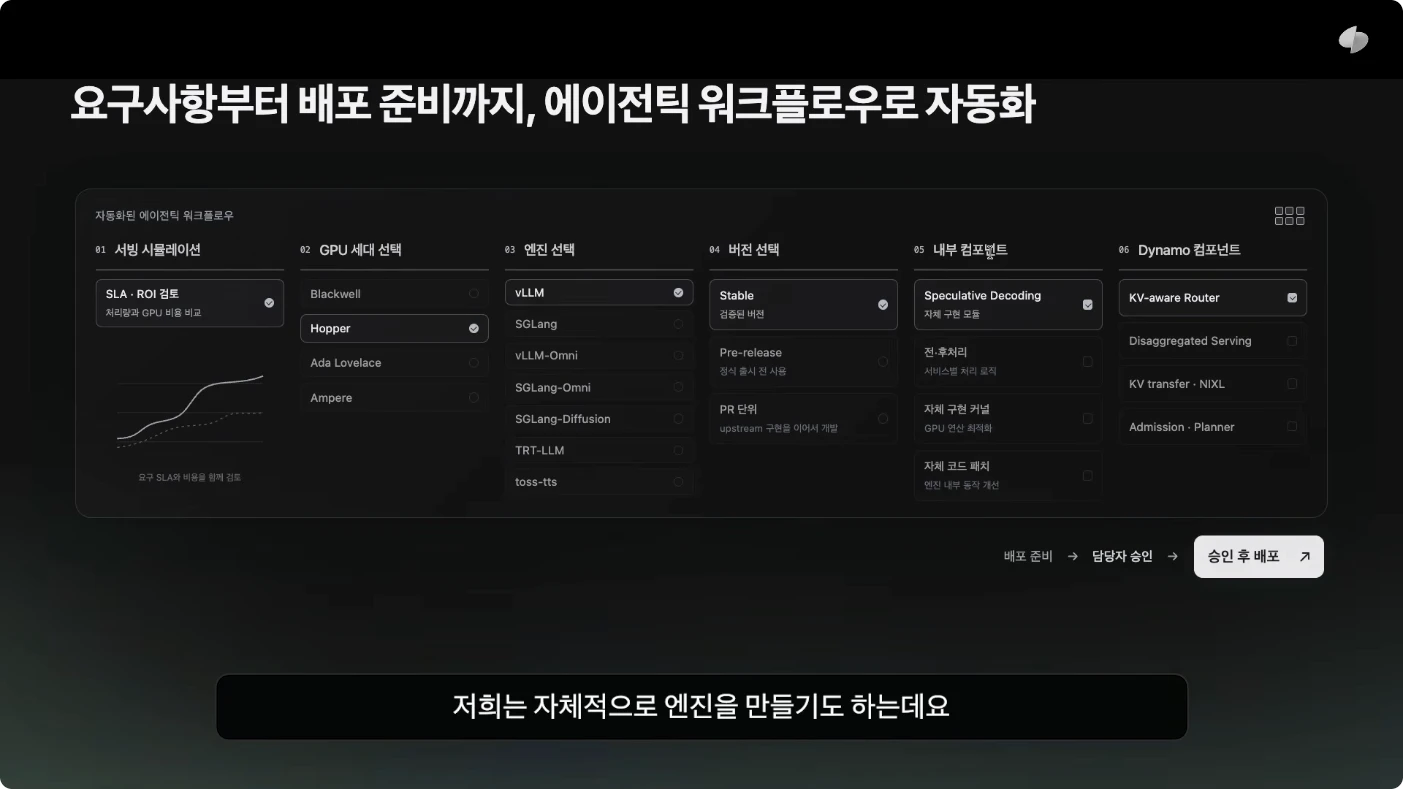
서빙 시뮬레이션, GPU와 엔진, 내부 최적화와 Dynamo 구성의 선택 흐름. 토스 챌린저스, 1:10
실제 요청을 받는 쪽에서는 KV 캐시를 고려하는 라우터, 과부하를 막는 admission control, 필요한 워커를 늘리는 Planner와 Grove가 연결된다. 그 아래에 추론 엔진과 GPU가 있고, KV 캐시는 GPU 메모리와 호스트 메모리, 저장장치로 이어진다. 관측도 별도 장식이 아니다. 어느 계층에서 시간이 새는지 알아야 다음 변경의 위치를 정할 수 있다.
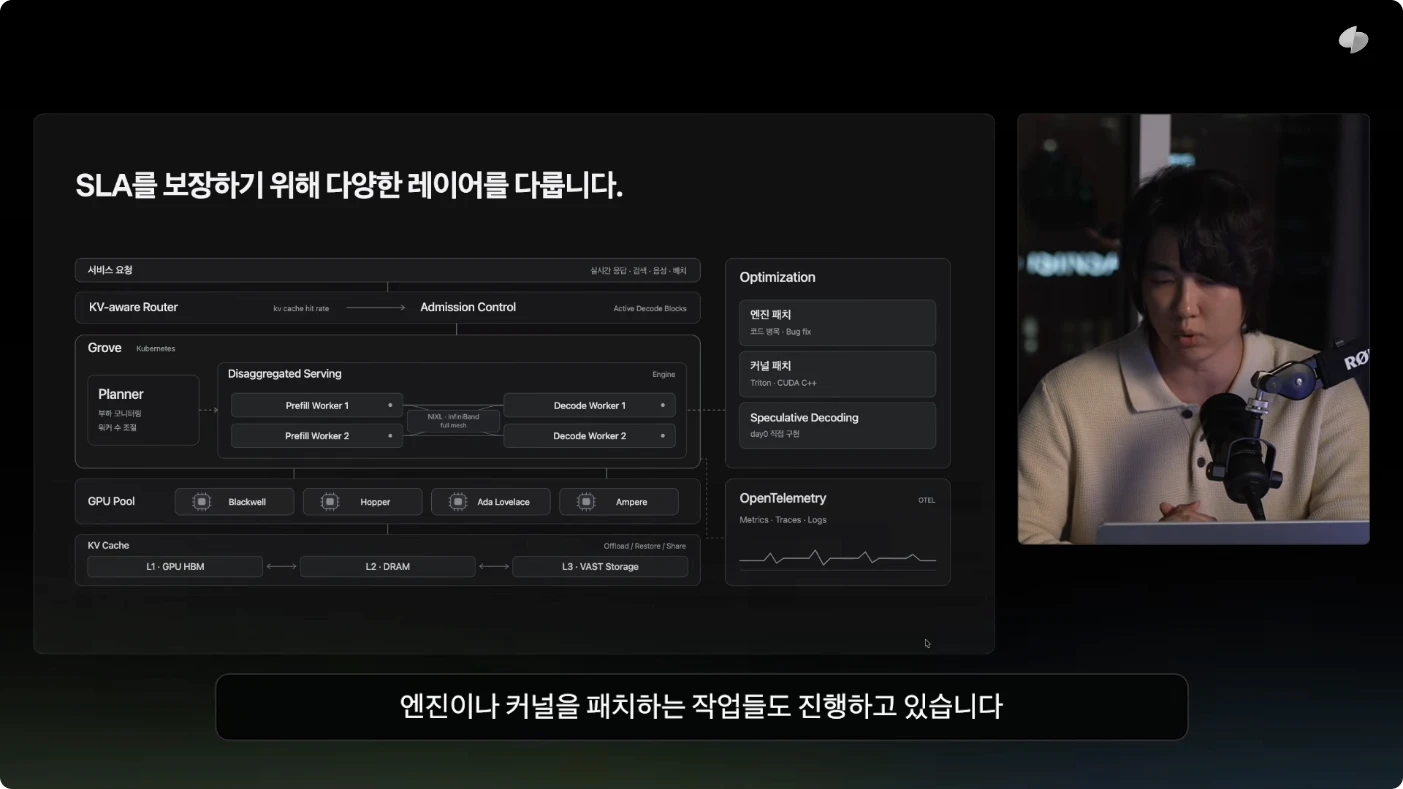
라우팅부터 엔진, GPU와 KV 캐시 계층까지 이어지는 서빙 구조. 토스 챌린저스, 3:12
TTS는 GPU가 일하기 전의 시간을 줄였다
발표 당시의 해당 TTS 모델은 vLLM-Omni 구성에서 RTF 1.40, TTFA 6,305ms가 나왔다. 실시간 재생을 따라가지 못하고, 첫 음성을 듣기까지도 6초가 넘는다. 다른 엔진은 도입 시점에 해당 모델 지원이 충분하지 않았다. 모델의 음성 품질을 확보한 상태에서, 서빙 지연이 서비스 출시를 막고 있던 셈이다.
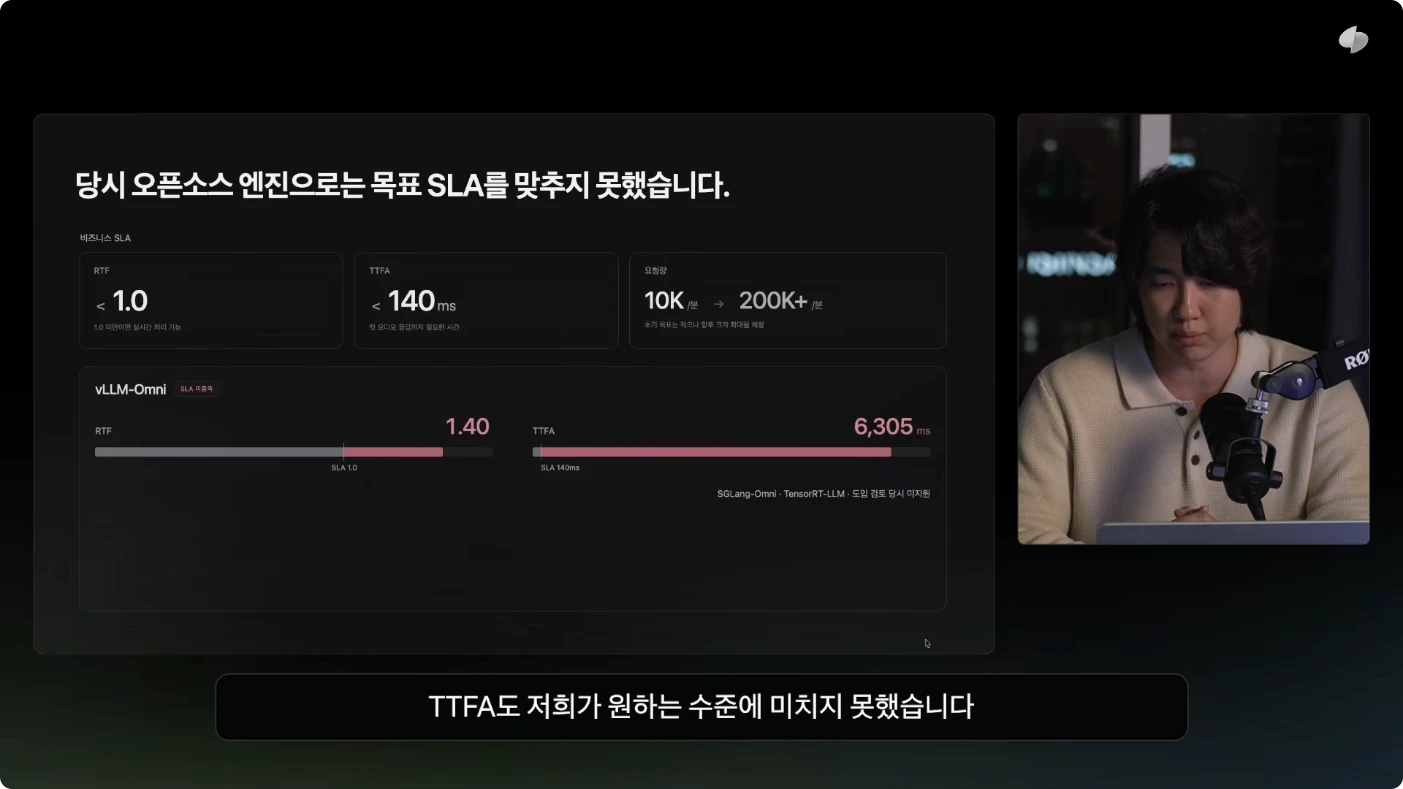
당시 모델과 엔진 조합에서 목표를 넘긴 RTF와 TTFA. 토스 챌린저스, 4:30
프로파일링 결과는 단순히 GPU 계산이 오래 걸린다는 예상과 달랐다. 화면의 AR 추론 스텝에서는 프레임워크 비용이 약 104ms, GPU 연산이 약 5ms로 제시된다. 프레임워크 비중은 95.4%. 이는 첫 오디오까지의 6,305ms 전체를 분해한 비율이 아니라, 화면에 표시된 추론 스텝의 분석이다.
오디오 모델은 Talker와 Predictor 등 여러 단계를 거칠 수 있고, 내부에서 작은 연산과 반복 호출이 이어진다. 매번 스케줄링하고 연산을 호출한 뒤 다음 단계로 넘기는 비용이 쌓이면 GPU가 계산을 끝내도 다음 일을 바로 받지 못한다. GPU를 더 빠른 것으로 바꿔도 CPU 쪽 호출과 스케줄링 대기가 그대로 남는 구조다.
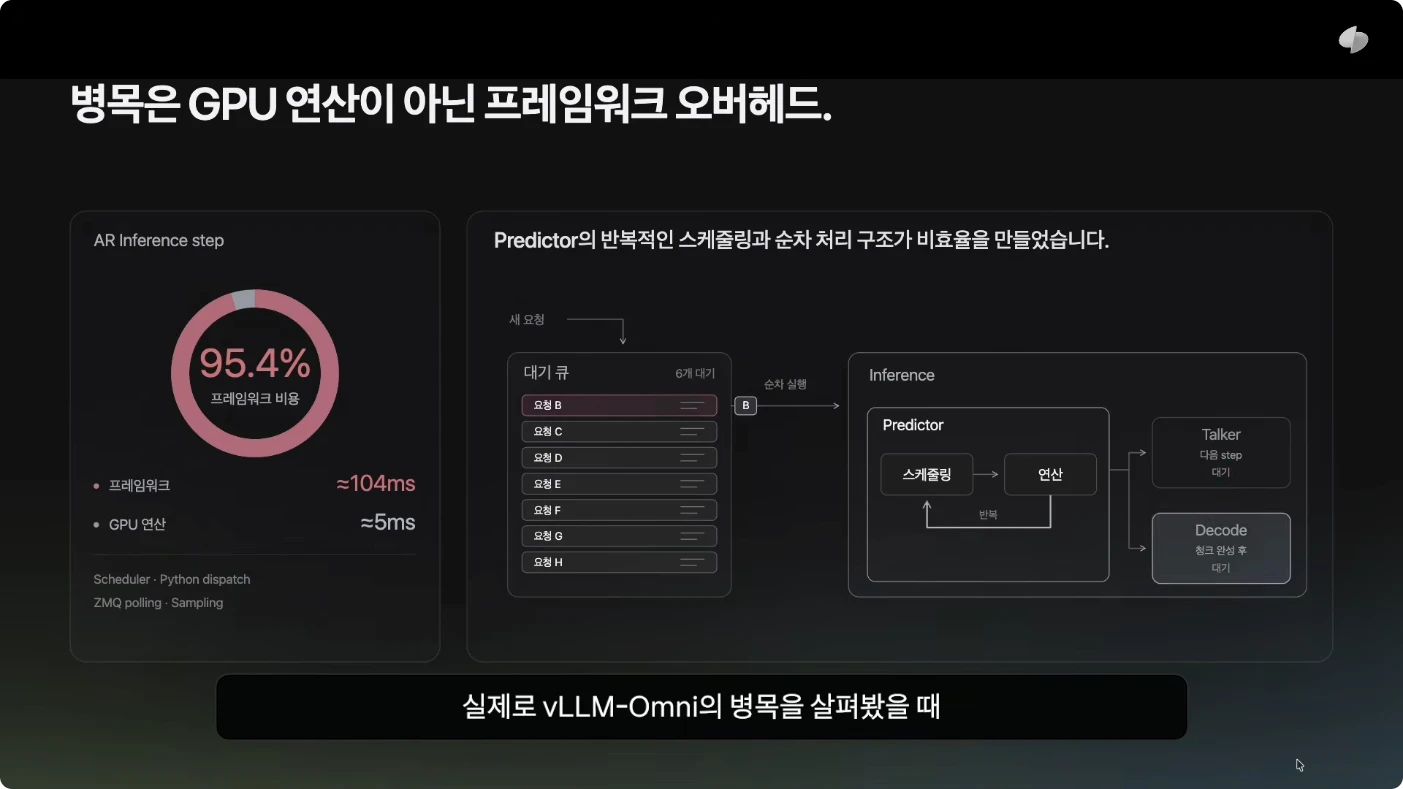
AR 추론 스텝의 프레임워크 오버헤드와 반복 스케줄링 구조. 토스 챌린저스, 5:20
여기서 CUDA Graph가 역할을 한다. 반복되는 GPU 작업을 그래프로 기록한 뒤, 매번 각 연산을 따로 호출하는 대신 묶어서 재실행한다. CPU가 Python과 C++, 드라이버 계층을 거치며 커널을 하나씩 준비하는 비용을 줄이는 방식이다. PyTorch 공식 설명도 주된 이점을 CPU 호출 오버헤드 감소로 설명한다.
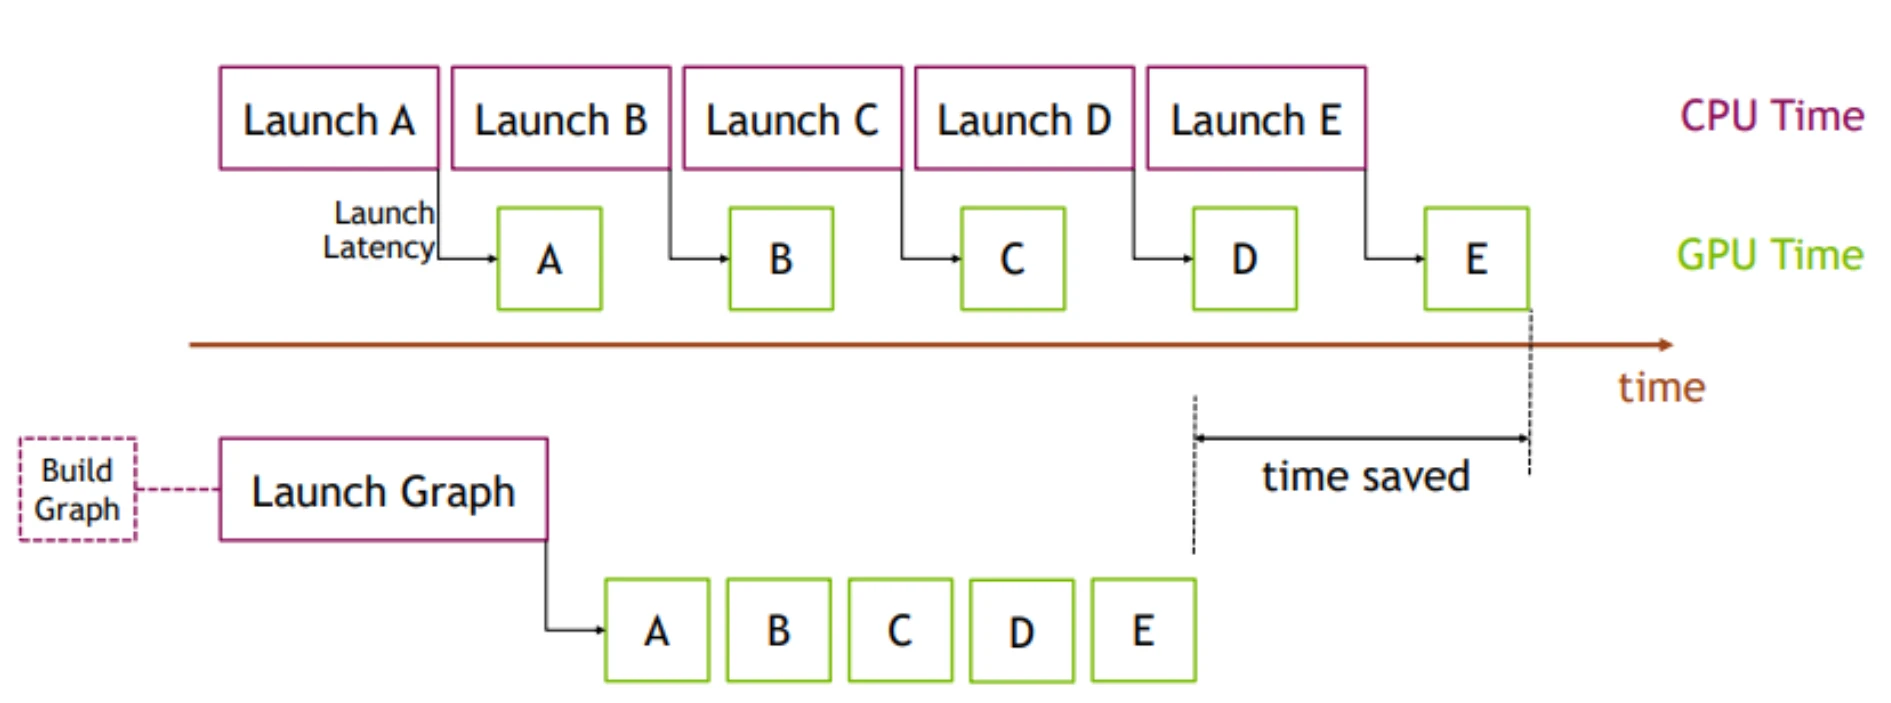
개별 커널 호출을 한 번의 그래프 실행으로 묶는 원리. 실제 시간 비율을 나타낸 성능 그래프가 아닌 개념도. PyTorch, Accelerating PyTorch with CUDA Graphs
토스는 모델별로 배치 처리가 가능한 범위의 그래프를 여러 개 만들고, 비동기 스케줄러를 구현해 그래프 연산이 계속 이어지도록 했다. CUDA Graph는 같은 메모리 주소와 정해진 텐서 형태를 재사용하는 제약이 있으므로, 크기와 흐름이 다른 요청을 어떤 그래프로 보낼지도 엔진이 관리해야 한다. 그래프 안에 넣은 CPU 코드까지 자동으로 재실행되는 기능으로 이해하면 안 된다.
이 엔진은 기존 서빙 시스템의 엔진 자리만 바꿔 끼울 수 있도록 구성했다. 모든 TTS를 자체 엔진으로 옮기는 것도 아니다. 주요 오픈소스 엔진을 선택지로 유지하고, SLA를 맞추기 위해 추가 최적화가 필요한 모델에 자체 엔진을 선택한다.
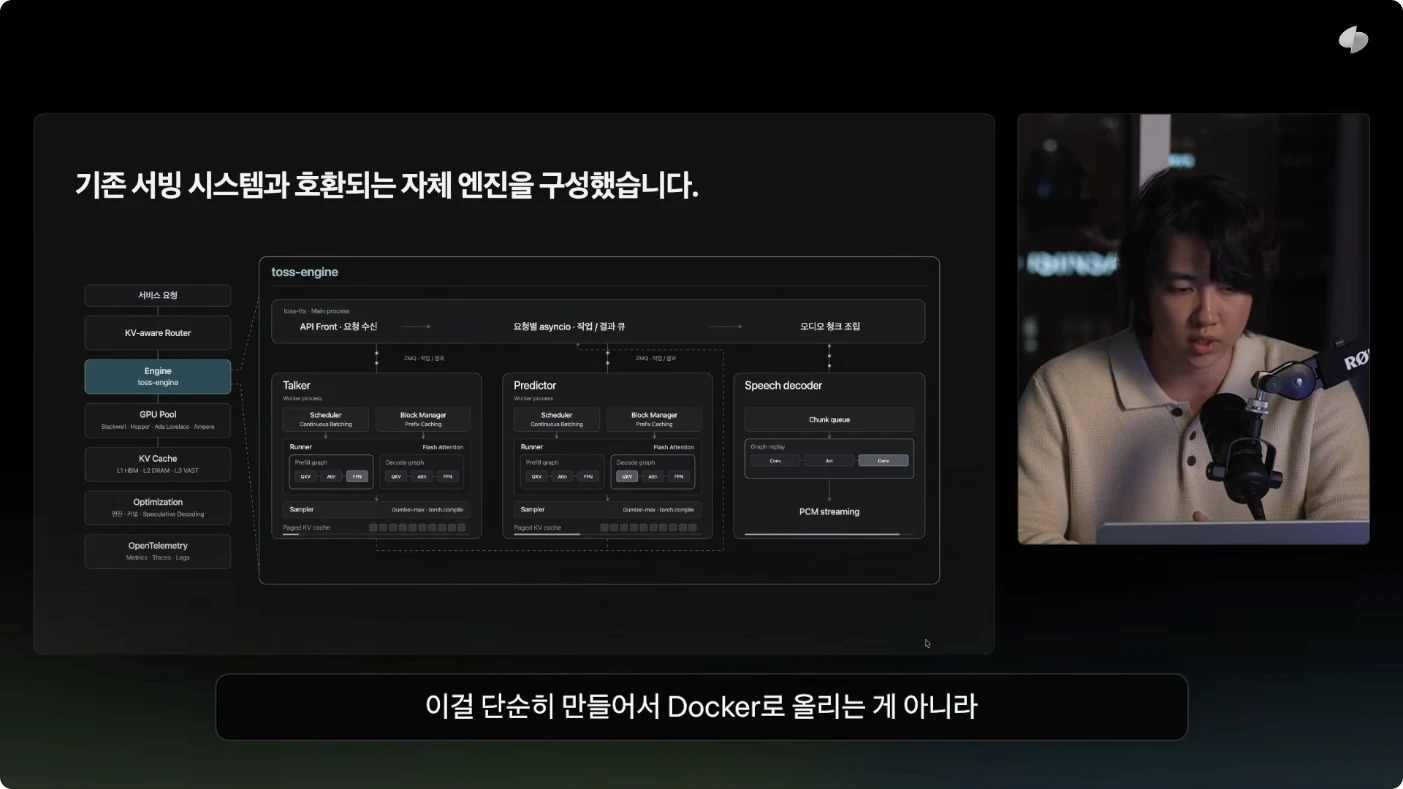
기존 라우팅과 GPU 관리 구조 안에 들어가는 자체 TTS 엔진. 토스 챌린저스, 6:05
최종 발표값은 RTF 0.31, TTFA 107ms였다. RTF는 약 4.5배 개선됐고 첫 오디오 지연은 약 59배 줄었다. 발표에서는 이를 약 60배로 설명한다. 처리량 화면에는 분당 27K 요청이 제시됐다. 발표 화면의 단위는 요청/분이다.
| TTS 지표 | 발표의 기존 vLLM-Omni 구성 | 자체 엔진 결과 | 목표 |
|---|---|---|---|
| RTF | 1.40 | 0.31 | 1.0 미만 |
| 첫 오디오까지의 시간 | 6,305ms | 107ms | 140ms 미만 |
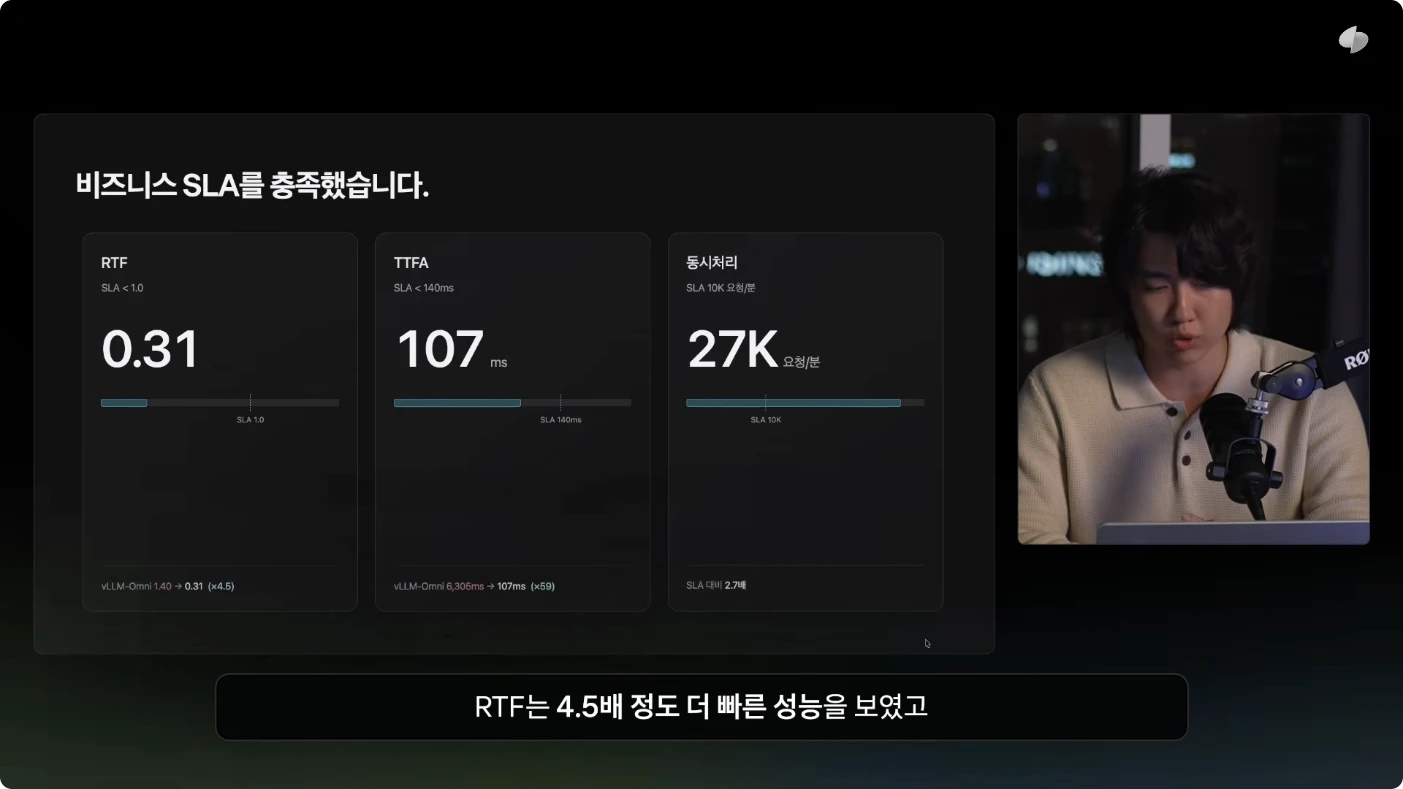
발표에 제시된 TTS 최적화 결과. 토스 챌린저스, 6:45
이 사례의 성과는 응답 시간을 줄여 실제 상담 서비스가 요구한 기준 안에 들어왔다는 데 있다. 병목을 측정하고, 그 시간을 만드는 실행 구조를 바꾼 결과다.
요청이 늘면 계산을 나누고, 캐시와 부하를 함께 본다
발표에는 전체 처리 규모가 하루 195B+ 토큰, 분당 135M+ 토큰으로 제시된다. 당시 토스가 다루던 모델도 40종 이상이었다. 요청의 크기와 응답 길이, 필요한 지연 수준이 다른 모델을 모두 같은 구성으로 처리하기 어려운 이유다.
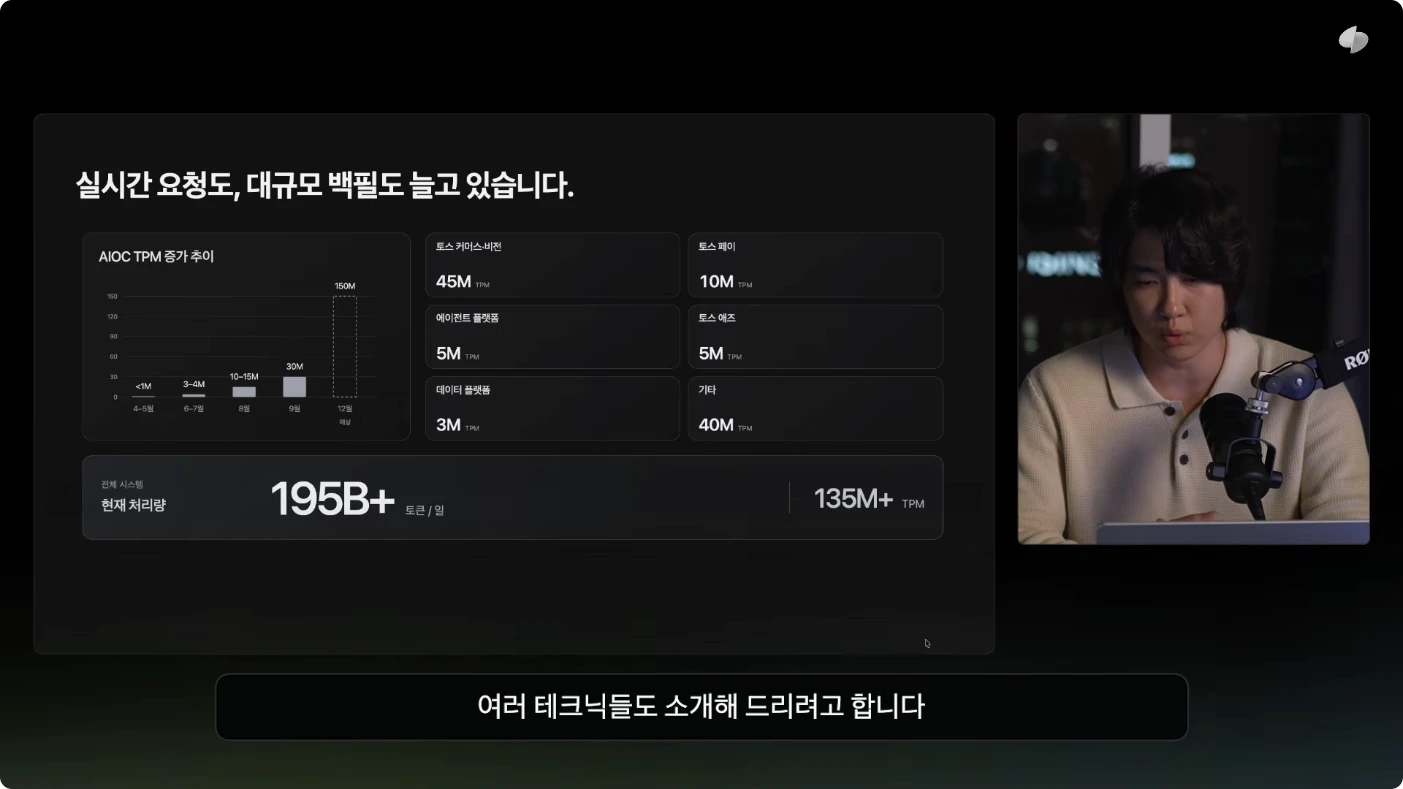
발표 당시 서비스별 요청 규모와 전체 토큰 처리량. 왼쪽 AIOC 그래프의 12월 150M TPM은 예상값. 토스 챌린저스, 7:20
LLM 추론은 입력을 읽는 prefill과 답변 토큰을 이어 만드는 decode로 나누어 볼 수 있다. 입력이 긴 요청은 prefill 작업이 커지고, 긴 답변은 decode 단계를 오래 점유한다. Aggregated serving은 두 단계를 같은 워커가 맡고, disaggregated serving은 역할을 나누어 각각의 워커에서 처리한다. 분리하면 두 단계의 필요량에 맞춰 자원을 배분하기 쉬워지는 대신, 단계 사이에 KV 캐시를 전달하는 비용이 생긴다.
토스는 기본적인 통합 구성에서 시작해, 필요한 모델에는 분리 구성을 선택한다. 설정을 바꾸면 해당 구조의 배포와 테스트, 벤치마크가 이어지고 그 결과로 결정한다. 분리 자체를 목표로 삼지 않고, 해당 모델의 요청 패턴에서 이득이 나는지를 판단하는 것이다.
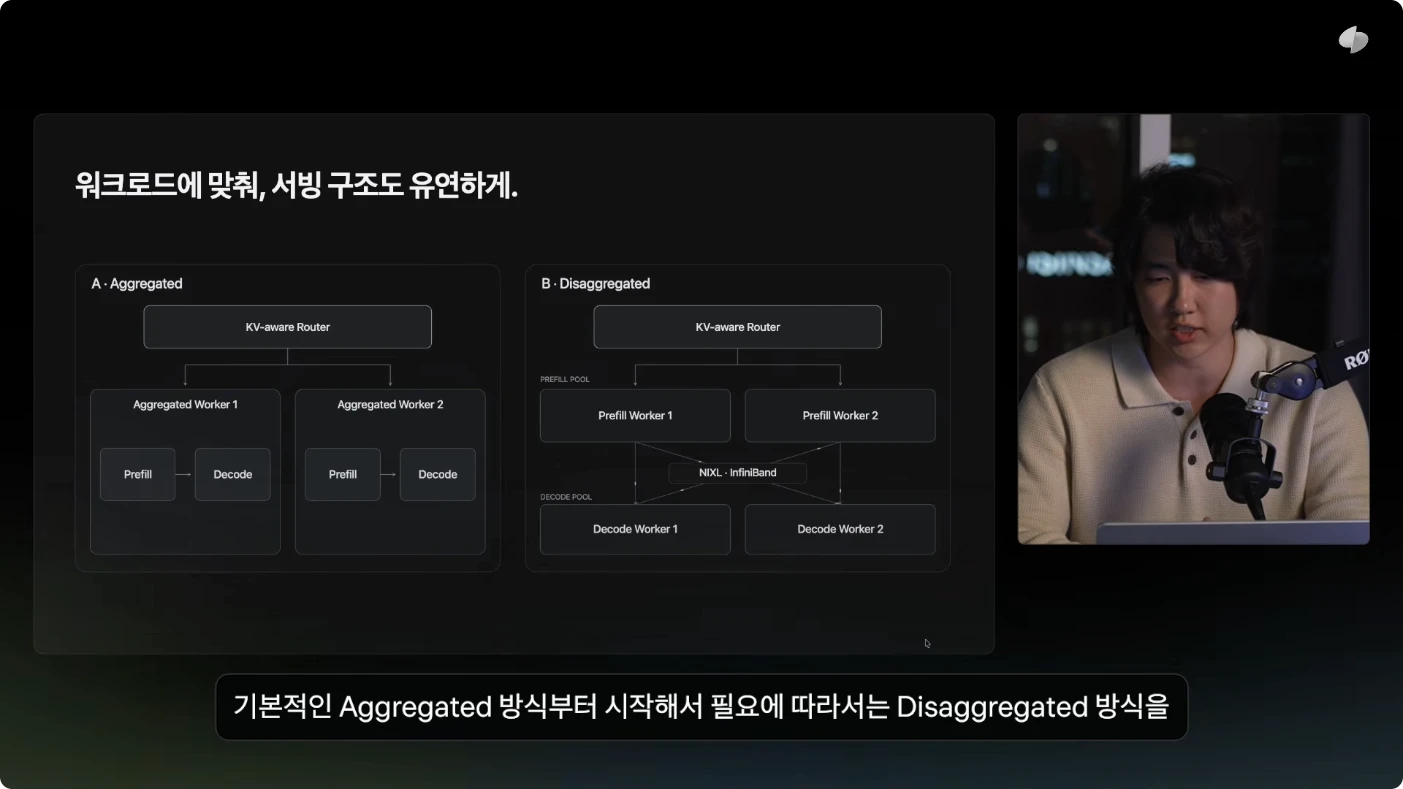
같은 워커에서 처리하는 구성과 prefill, decode를 나눈 구성. 토스 챌린저스, 7:45
두 구성에 공통으로 적용하는 것이 KV-aware routing이다. KV 캐시는 앞서 읽은 토큰의 어텐션 계산 결과 중 재사용할 수 있는 상태다. 같은 접두부를 가진 요청을 그 상태가 남아 있는 워커에 보내면 처음부터 다시 계산하는 일을 줄일 수 있다.
문제는 캐시가 많이 쌓인 워커가 계속 선택될 수 있다는 것. 이미 바쁜 워커에 요청을 더 보내면 계산을 절약한 이익보다 대기 시간이 커진다. 토스는 캐시 재사용에 더해 부하 페널티를 적용해 한쪽으로 쏠리는 현상을 줄였다. Dynamo의 라우터 문서도 캐시 중복과 활성 부하 사이의 균형을 조절하도록 설명한다. 캐시 적중률이 높다는 사실만으로 응답 시간이 짧아지는 것은 아니어서, 재사용과 대기를 함께 비용으로 보는 셈이다.
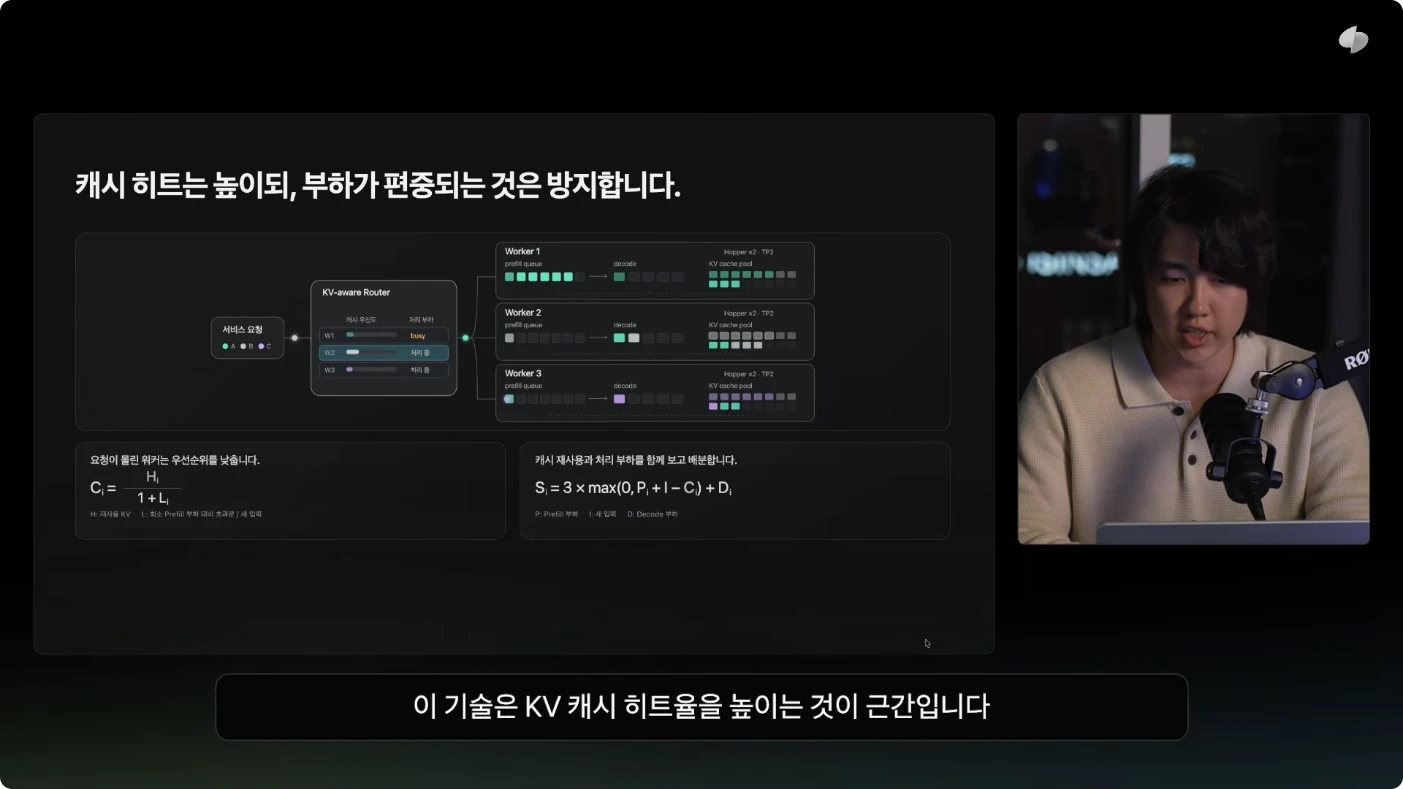
캐시 재사용 이득과 워커 부하를 함께 반영하는 라우팅. 토스 챌린저스, 8:10
순간적인 폭주와 지속적인 증가는 다르게 처리한다
긴 입력이나 큰 이미지가 섞이거나 요청이 한꺼번에 몰리면, 처리 가능한 범위를 넘어서는 순간 응답 시간이 급격히 나빠진다. 이미 받아 놓은 일을 끝내지 못하는 상태에서 계속 새 요청을 넣으면 대기열만 길어진다.
Admission control은 이 경계에서 요청을 받을지 결정한다. 발표에서는 활성 decode 블록 수를 기본 신호로 삼고, prefill 부하와 대기 중인 요청 수까지 고려한다고 설명한다. 정한 안전선을 넘는 요청은 HTTP 429로 거절하고 호출 측의 재시도나 대체 경로로 넘긴다. 화면의 80%는 설명에 사용된 기준값이며, 모든 모델에 그대로 적용하는 공통 최적값으로 볼 수는 없다.
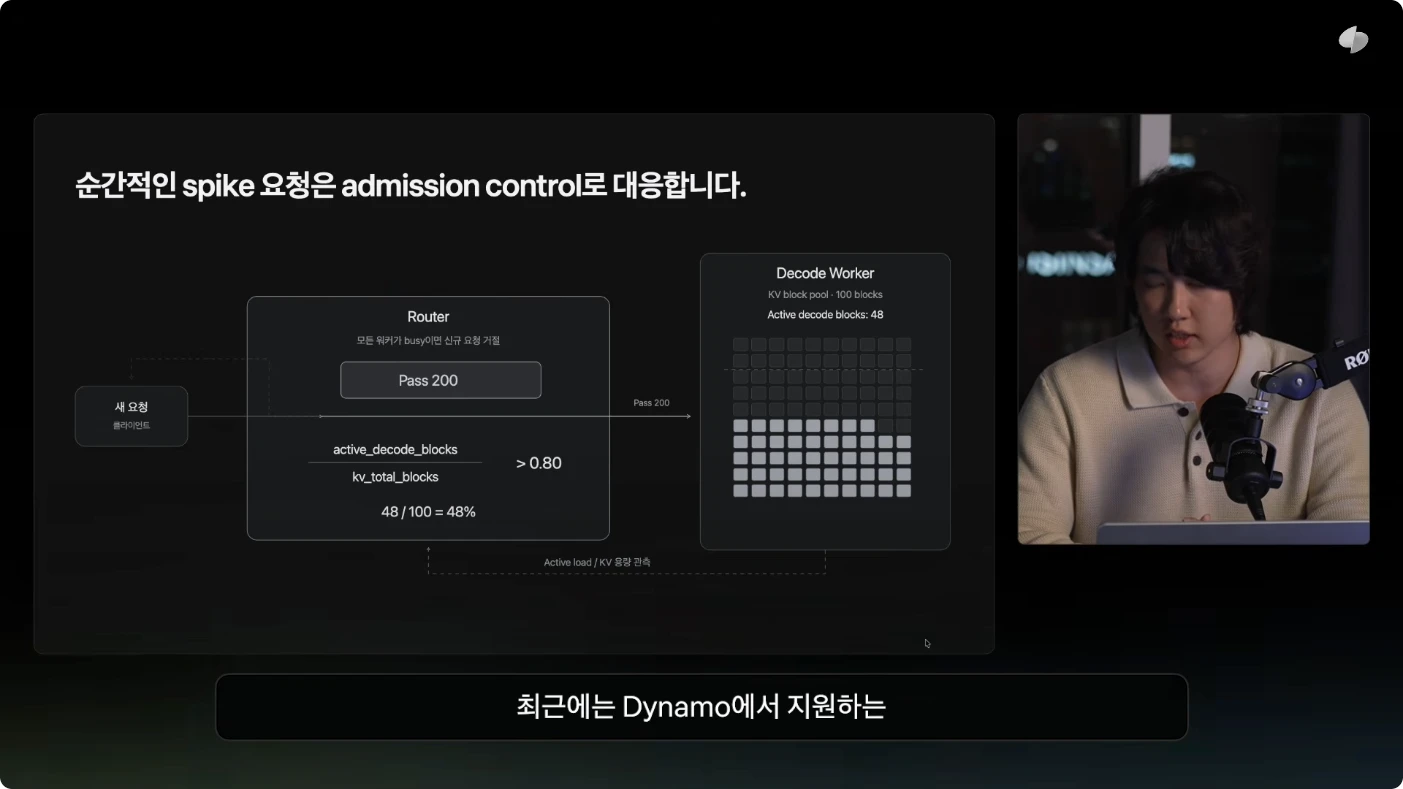
활성 decode 블록의 비율과 안전선을 기준으로 요청 수용을 판단하는 예시. 토스 챌린저스, 9:10
반면 부하가 계속 높게 유지되면 실제 처리 용량을 늘려야 한다. 토스는 prefill과 decode 중 어느 쪽에 부하가 쌓이는지 계산하고, Dynamo의 Planner와 Grove를 이용해 워커를 확장한다. 발표에서는 GPU들이 InfiniBand로 연결돼 있다고 설명한다. 역할을 나눈 워커 사이의 KV 전달과 확장에는 이런 연결 조건도 중요해진다.
공식 문서에서 Planner는 부하나 지연 목표에 따라 필요한 복제본 수를 판단하는 계층이다. Grove는 서로 관련된 추론 워크로드의 구조와 생명주기를 Kubernetes에 표현한다. 무엇을 얼마나 늘릴지와, 필요한 구성요소들을 어떻게 함께 배치할지가 이어진다.
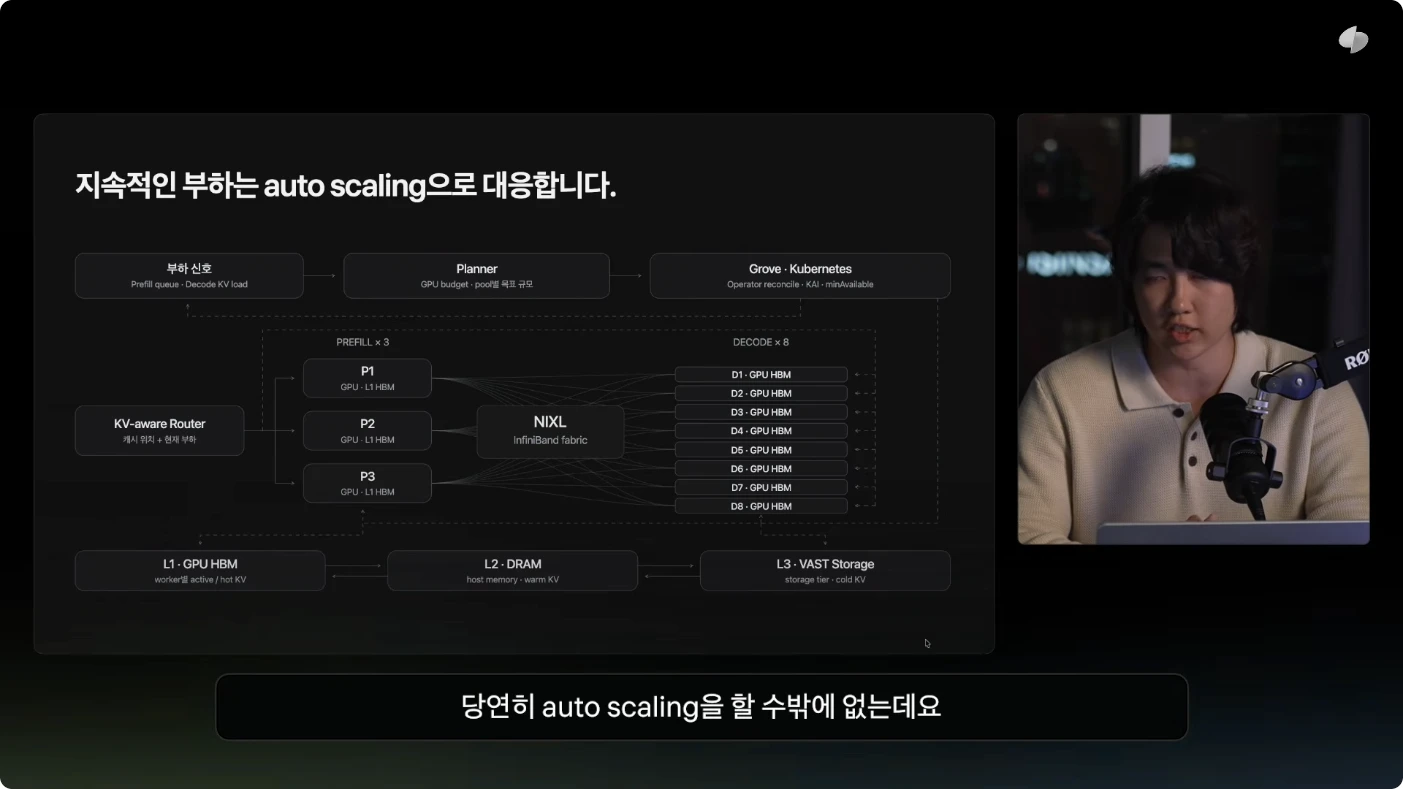
부하를 읽는 Planner, 배치를 관리하는 Grove, 분리된 prefill과 decode 워커. 토스 챌린저스, 9:40
KV-aware routing은 기존 자원을 더 잘 쓰게 하고, admission control은 갑작스러운 과부하에서 처리 중인 요청을 보호한다. Autoscaling은 계속 늘어난 수요에 맞춰 용량을 추가한다. 세 기능은 서로 다른 시간대와 문제를 맡는다.
엔진을 띄운 뒤에도 모델별 실행 경로를 고친다
같은 vLLM을 사용해도 모델 구조에 따라 선택되는 커널과 병목은 달라진다. 발표의 Gemma 사례에서는 sliding attention과 full attention의 head dimension이 달랐고, 당시 구현이 Triton 커널 경로를 사용하고 있었다. 토스는 sliding attention에는 FlashAttention 3, full attention에는 FlashAttention 4를 적용하는 식으로 실행 경로를 바꾸고, 회귀 테스트로 결과를 검증했다.
Attention 계산을 여러 SM에 나누는 병렬화도 점검한다. SM은 GPU에서 연산을 수행하는 실행 단위다. 작업이 일부에만 몰리면 다른 실행 단위가 남으므로, 계산을 나누고 결과를 합치는 구조가 성능에 영향을 준다. MoE 커널도 요청 크기에 맞춰 선택한다. 화면에서는 현재 실행의 입력 토큰 수 M이 256보다 작을 때 Marlin, 256 이상일 때 CUTLASS를 선택하는 예가 나온다. 이 기준 역시 해당 구현에서 선택한 경로다.
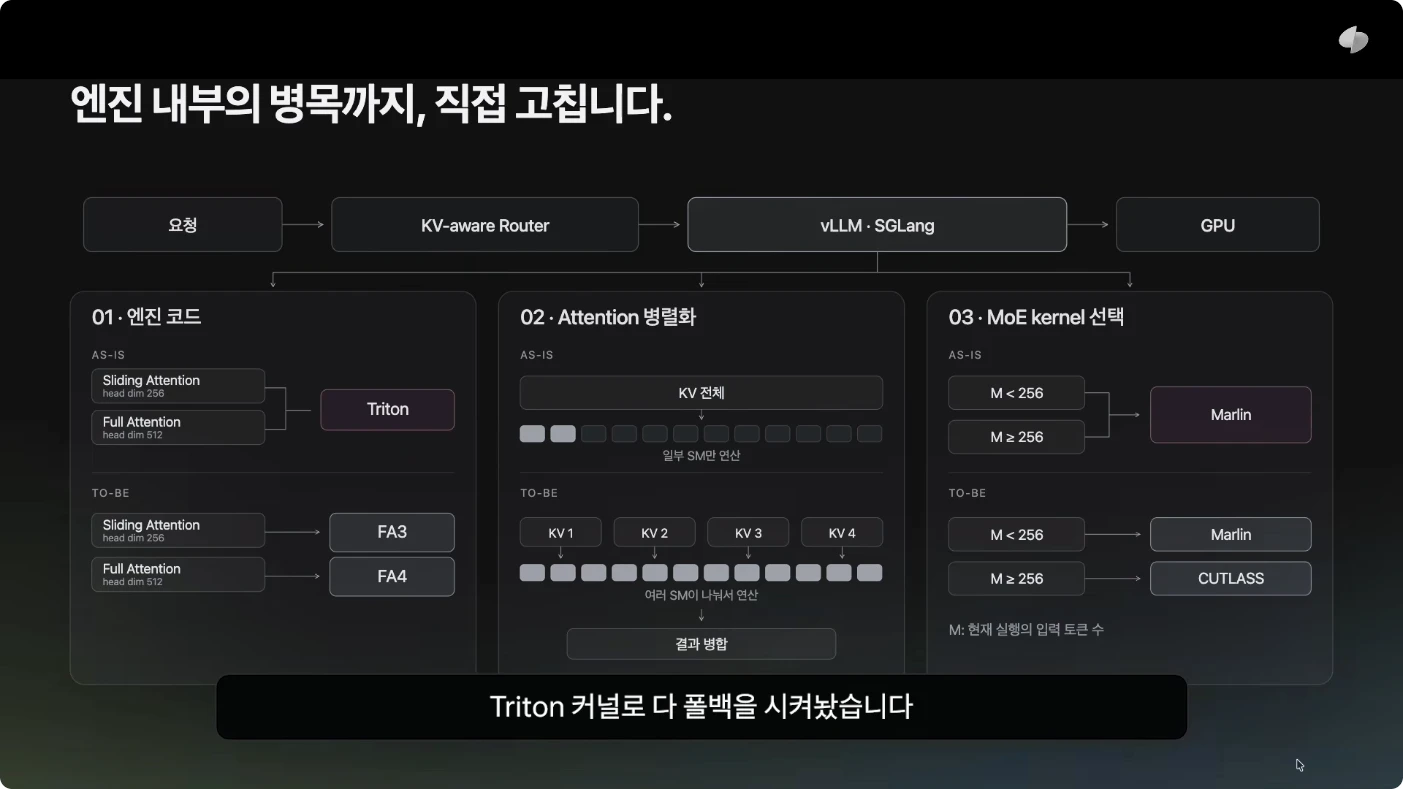
어텐션별 커널 선택, SM 병렬화, 입력 크기에 따른 MoE 커널 분기. 토스 챌린저스, 11:05
발표의 Gemma 4 26B 결과는 TTFT p50 42.1ms, 출력 속도 503.25 tokens/s, TPOT 1.99ms다. TTFT는 첫 토큰이 나올 때까지의 시간, TPOT는 이후 출력 토큰당 시간이다. 여기서는 토스가 제시한 구성의 결과로 읽으면 된다.
이런 수정은 엔진 버전 하나를 고르는 일보다 유지할 것이 많다. 어떤 모델과 입력에서 패치를 켤지, 출력이 바뀌지 않는지, 다음 버전에서 같은 수정이 필요한지 계속 확인해야 한다. 발표에서 프로파일링과 회귀 테스트, 오픈소스 기여를 함께 이야기하는 이유도 여기에 있다.
출시 당일 서빙에는 빠른 패치와 검증이 함께 필요하다
GLM-5.3-Flash 사례에서는 모델 가중치가 공개된 날 바로 서비스할 필요가 있었다. 그런데 DFlash2 같은 speculative decoding 연결이 빠져 있거나, 분산 처리 경로에서 서버가 종료되는 문제가 있었다고 한다. 토스는 필요한 중간 출력의 연결과 tensor parallelism 경로의 오류를 고쳐 당일 서빙에 적용했다.
Speculative decoding은 후보 토큰을 여러 개 먼저 제안하고 target 모델이 묶어서 검증하는 방식이다. 매번 비싼 모델로 한 토큰씩 순차 생성하는 횟수를 줄일 수 있다. vLLM의 공식 설명에서도 proposer와 검증 경로를 구분한다. 후보를 만든다는 사실만으로 빨라지는 것은 아니며, 검증을 통과하는 비율과 후보 생성 비용이 실제 이득을 좌우한다.
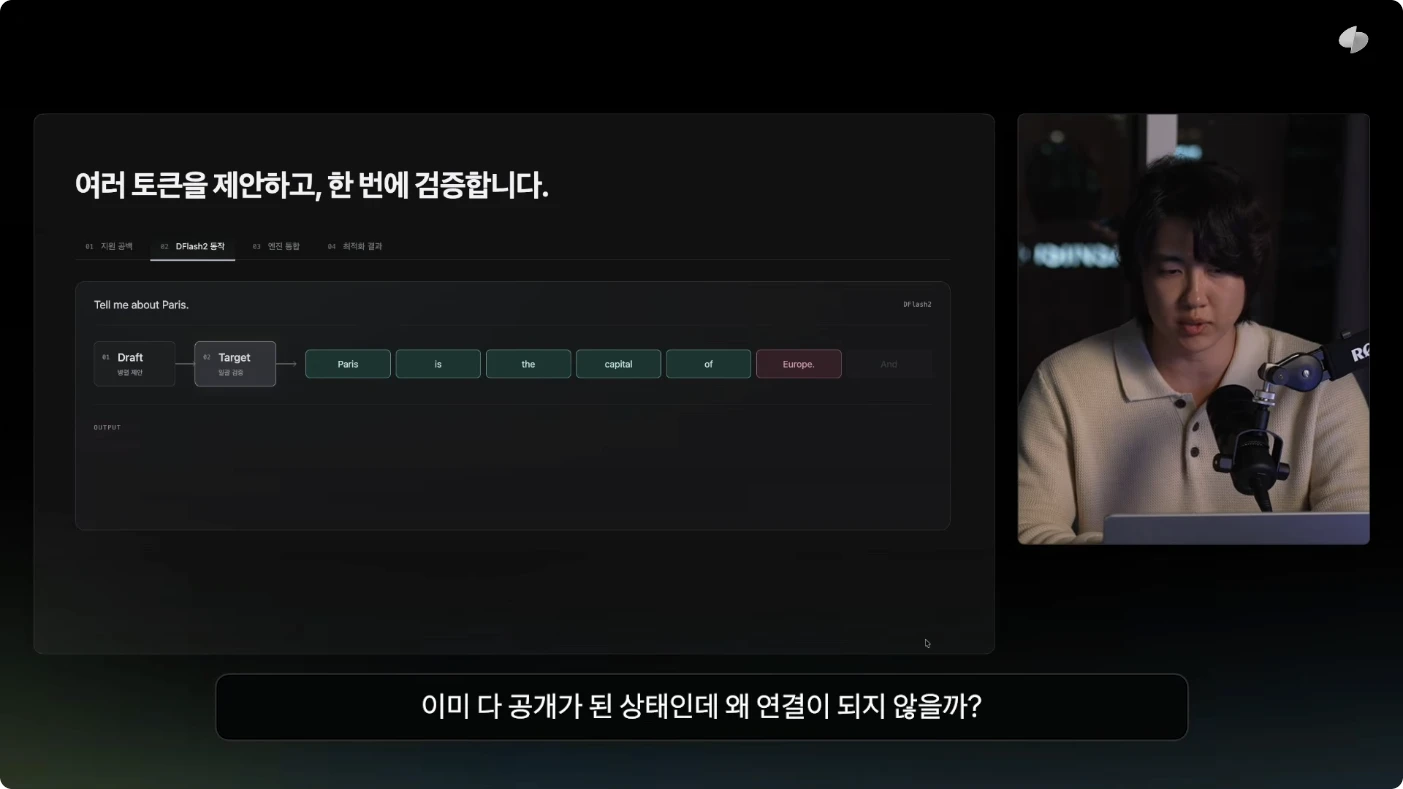
여러 후보 토큰을 제안한 뒤 한 번에 검증하는 흐름. 토스 챌린저스, 13:20
해당 GLM-5.3-Flash 최적화 결과 화면에는 유저당 생성 속도 5.2배, 전체 처리량 2.2배 개선이 제시된다. TTFT는 4.28초에서 0.33초, TPOT는 18.61ms에서 3.49ms로 바뀌었다. 한 사용자가 체감하는 생성 속도와 시스템 전체가 처리하는 양은 서로 다른 지표라서 개선 배율도 다르다. 이 값은 발표의 최적화 전후 구성 비교이며, speculative decoding 하나의 독립 효과로 분리해 측정한 결과라고 확대하지 않는다.
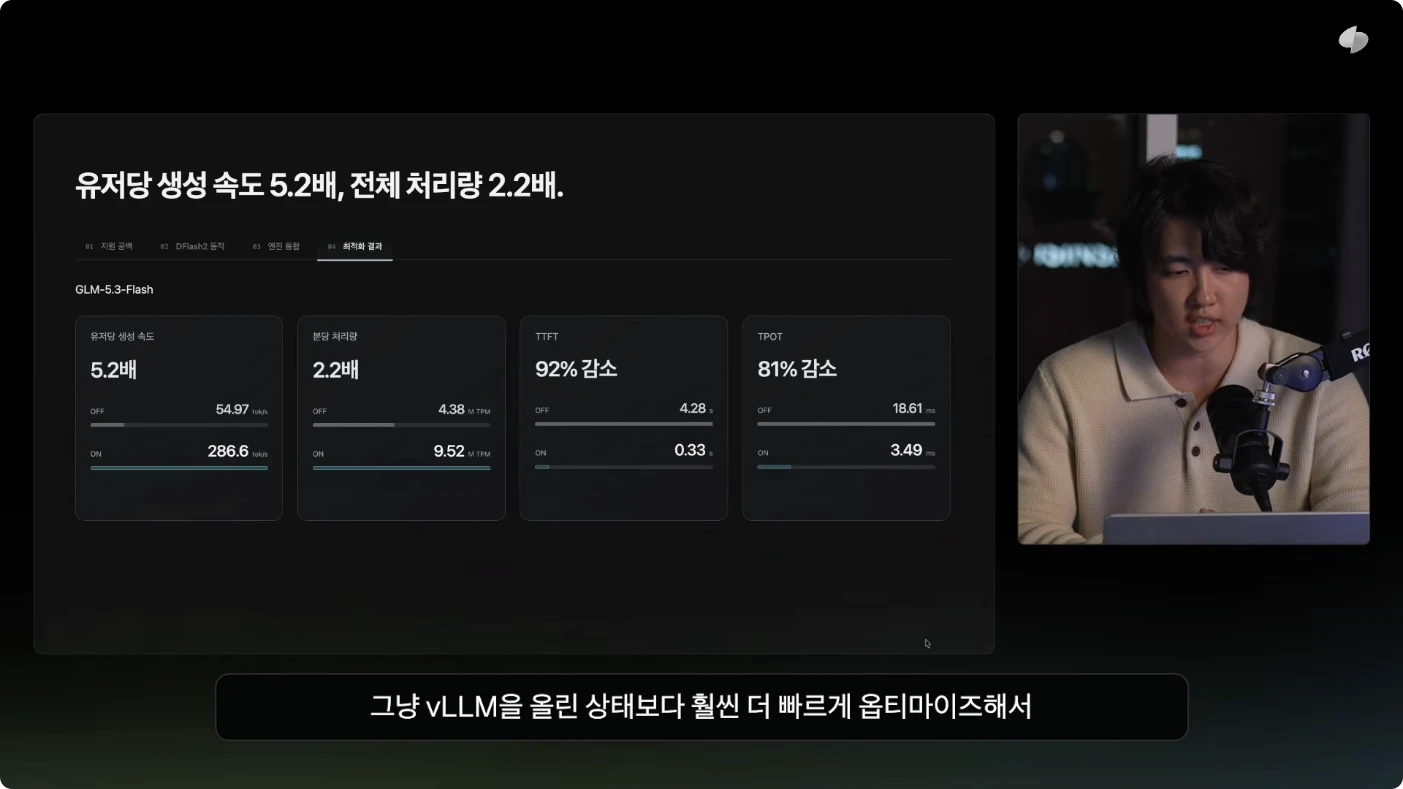
GLM-5.3-Flash 최적화 전후의 사용자 생성 속도와 전체 처리량. 토스 챌린저스, 14:05
Day 0 서빙을 가능하게 하는 것은 출시 소식을 빨리 보는 것만이 아니다. 실패한 실행 경로를 좁히고, 고친 부분이 출력과 분산 실행을 망가뜨리지 않았는지 검증할 수 있어야 한다. 그 능력이 있어야 모델 지원 일정이 외부 패치 일정에만 묶이지 않는다.
커널 지원을 넓히면 남는 GPU도 쓸 수 있다
주력 GPU가 바쁠 때 보조 GPU가 남아 있어도, 필요한 커널이 그 장비에서 실행되지 않으면 여유 자원을 활용하기 어렵다. 발표에서 GLM-5.2로 소개한 사례에서는 DSA 인덱서와 sparse MLA 경로가 Hopper 계열을 대상으로 만들어져 A100에서 그대로 실행하기 어려웠다.
DSA의 인덱서는 어텐션에 사용할 토큰을 고르고, sparse MLA는 선택한 위치의 KV를 이용해 계산한다. 토스는 이 경로를 A100에서도 실행하도록 BF16 기반의 Triton 커널을 개발하고 엔진에 연결했다. 모델 파일이 메모리에 들어가는 것과 실제 추론 경로가 GPU에서 작동하는 것은 별개라는 점이 여기서 드러난다.
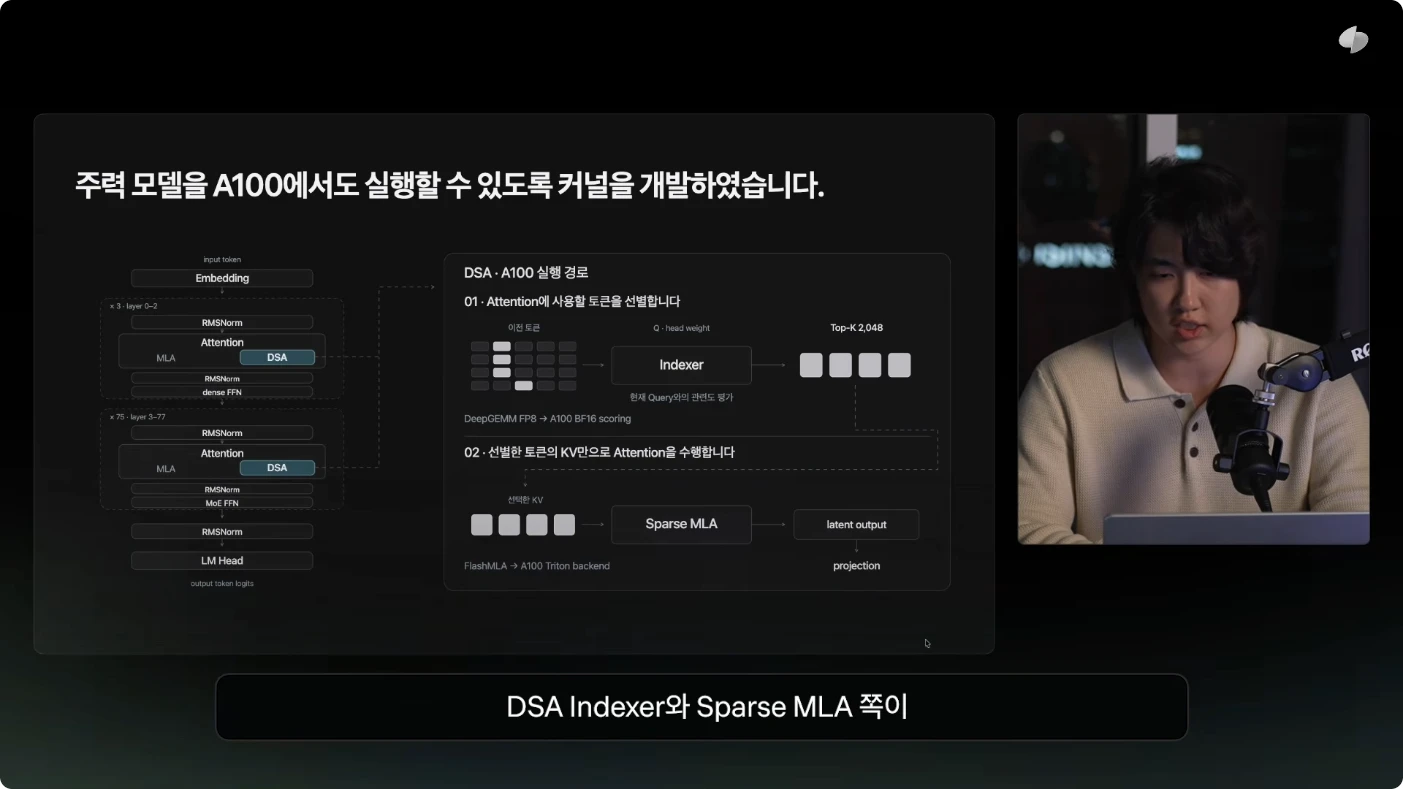
A100을 위한 DSA 인덱서와 sparse MLA 실행 경로. 토스 챌린저스, 15:00
작은 연산들을 합치는 operation fusion도 같은 층의 작업이다. 발표에서는 out = SiLU(gate) × up을 예로 든다. 활성화 함수를 계산한 중간 결과를 저장하고 다시 읽어 곱하는 대신, 필요한 작업을 하나의 커널로 합쳐 중간 메모리 접근과 호출을 줄인다. 이렇게 만든 CUDA C++ 커널을 Rust 코드베이스에 연결해 운영하는 구조도 보여 준다.
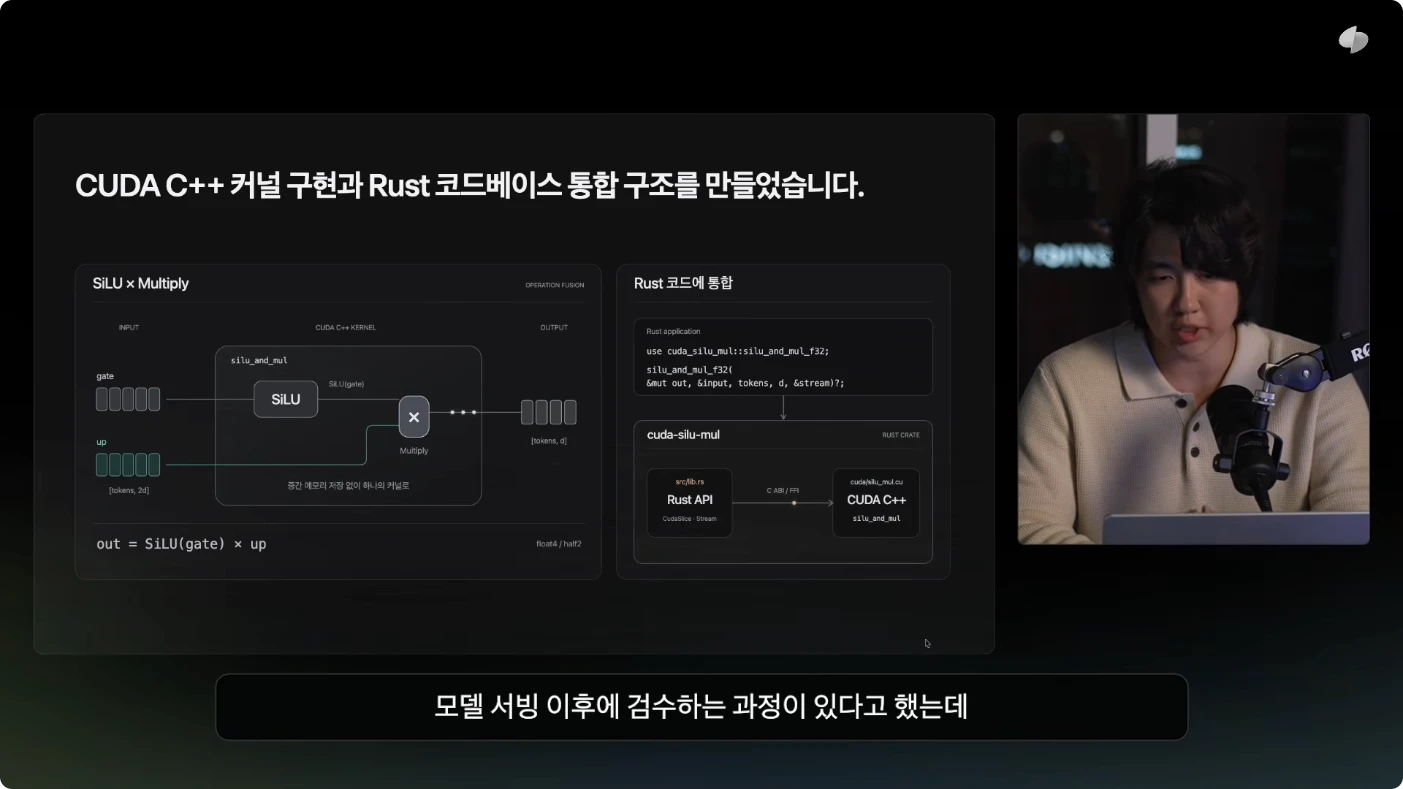
SiLU와 곱셈을 합친 커널을 Rust API에서 호출하는 구조. 토스 챌린저스, 15:50
이 지원 범위가 넓어지면 상위 게이트웨이는 Hopper와 Blackwell, Ada Lovelace 같은 서로 다른 GPU 풀의 용량을 고려해 요청을 보낼 수 있다. 남은 GPU에 일을 보내는 라우팅과, 그 GPU에서 일이 실제로 실행되도록 만드는 커널 개발이 연결되는 것이다.
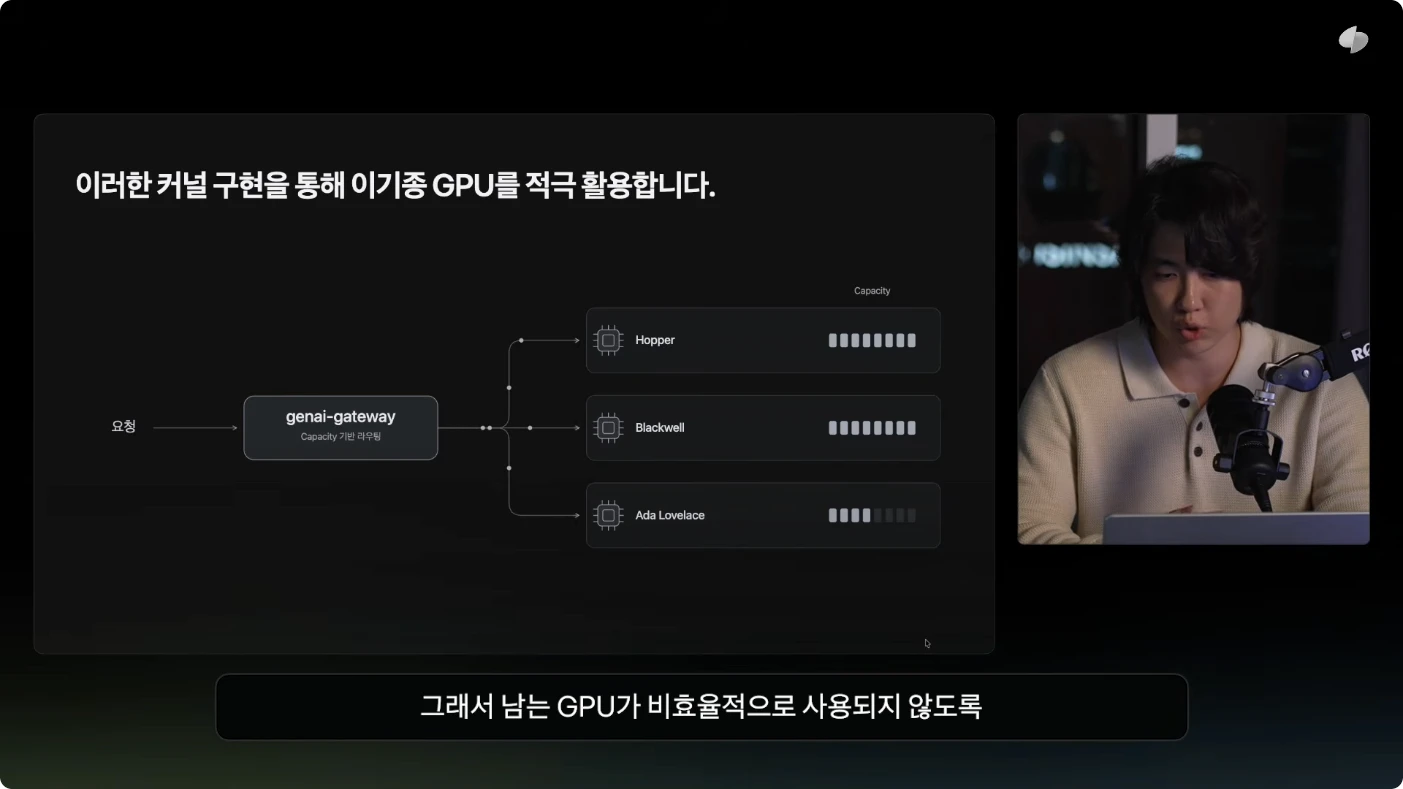
이기종 GPU 풀의 처리 용량을 반영하는 게이트웨이. 토스 챌린저스, 16:45
시간대도 자원 배분에 활용한다. 실시간 서비스가 많은 주간에는 그 요청을 우선하고, 수요가 줄어드는 야간에는 백필이나 배치 처리, 검수 작업을 수행한다. 같은 GPU를 계속 한 가지 작업에 묶어 두지 않고, 서비스의 수요 패턴에 맞춰 역할을 바꾸는 방식이다.
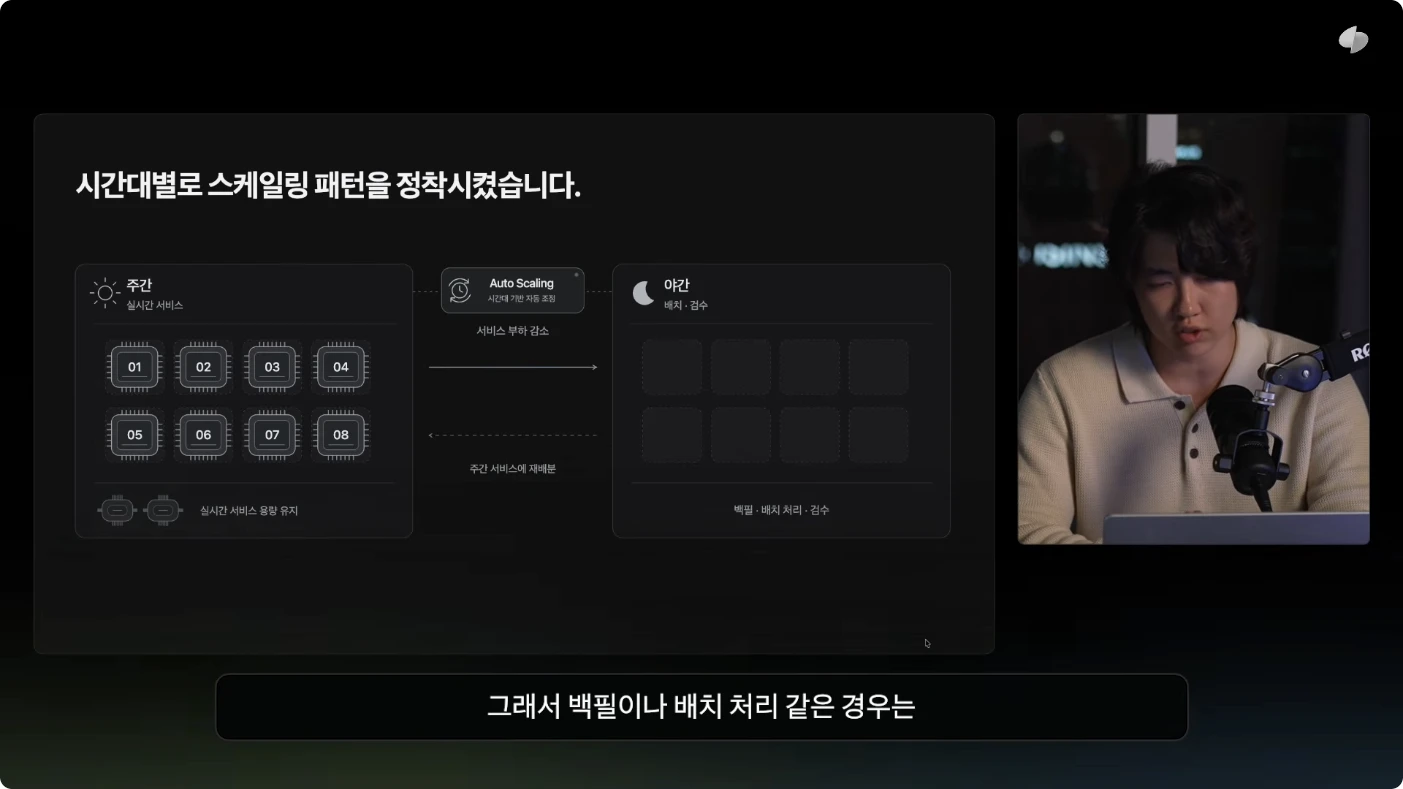
주간 실시간 서비스와 야간 배치 작업을 나누는 스케일링 패턴. 토스 챌린저스, 17:35
최적화의 결과를 다음 배포에 다시 쓴다
이 많은 선택을 매번 수동으로 수행하면 모델 수가 늘수록 서빙 팀이 막힌다. 발표 후반의 자동화는 모델 탐지에서 시작해 시뮬레이션, 업로드, 검증 환경 구성, 테스트, 벤치마크로 이어진다. 에이전트는 도구를 실행하고 결과를 해석하며 후속 작업을 이어 간다. SLA가 부족하면 최적화 단계로 돌아가고, 최종 배포 승인은 엔지니어가 맡는다.
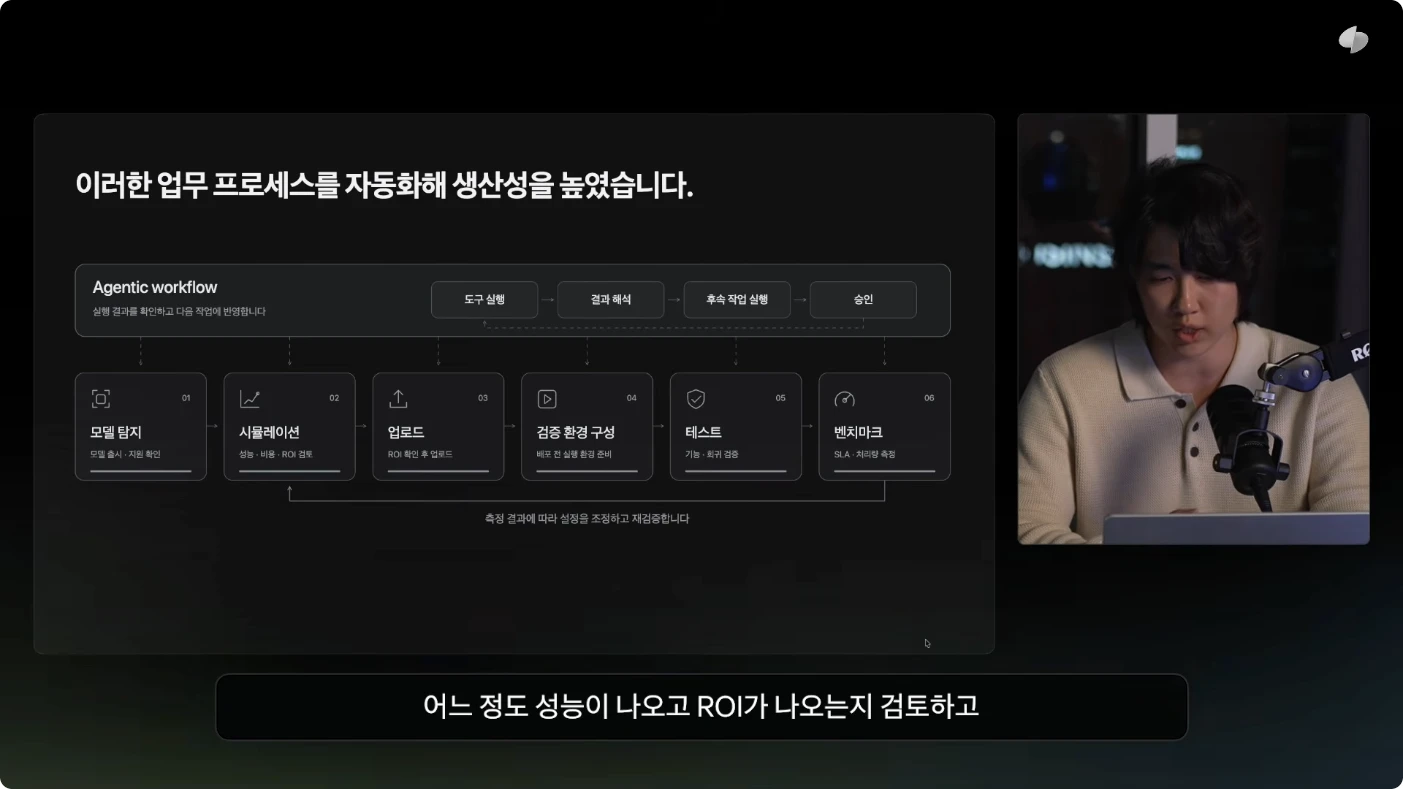
모델 탐지부터 시뮬레이션과 검증, 벤치마크, 승인으로 이어지는 작업 흐름. 토스 챌린저스, 18:20
시뮬레이션은 선택지를 좁히고, 실제 테스트와 벤치마크는 선택한 구성을 검증한다. 관련 공개 도구인 NVIDIA의 AISimulate도 목표 하드웨어에서의 검증을 대체하지 않는다고 명시한다. 발표의 흐름에서도 시뮬레이션 뒤에 검증과 벤치마크가 따로 있는 이유를 이해할 수 있다.
새 모델은 당일 제공을 목표로 하고, 새 버전이 나오면 마이그레이션하며 사용량이 낮은 모델은 내린다. 발표의 모델 목록은 이런 운영 이력을 포함한다.
마지막에 제시한 발전 단계는 빠른 제공을 위한 자동화와 CI/CD, 대규모 서비스의 SLA를 맞추기 위한 엔진과 커널 최적화, 그리고 아직 공개하지 않은 다음 단계였다. 먼저 새 모델을 안정적으로 제공할 수 있게 하고, 그 위에서 더 많은 요청과 더 까다로운 응답 시간을 감당하는 방향이다.
이 사례에서 가져갈 핵심은 측정과 수정의 연결이다. 사용자에게 필요한 시간을 정하고, 그 시간이 깨지는 계층을 찾고, 바꾼 구성을 다시 검증한다. 그 결과를 설정과 자동화에 넣어 다음 모델에도 이어 쓴다. 토스의 서빙 플랫폼은 이런 반복을 통해 모델 수와 트래픽이 함께 늘어나는 상황을 감당하고 있었다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/records/toss-ai-serving-sla-engine-kernel-workflow/index.md'