 Readiz
Attention Is All You Need: 트랜스포머 수식과 실험을 읽는 자료
원 논문의 행렬 차원, 기본 모델과 대형 모델, 학습과 생성의 차이, BLEU와 추정 FLOPs의 비교 기준을 정리한다.
글 관리 · 공개 범위Attention Is All You Need는 Vaswani 등 8명이 2017년에 발표한 트랜스포머 논문이다. 순환과 합성곱 없이 어텐션을 중심으로 입력과 출력의 문맥을 계산하는 번역 모델을 제안했다. 이 문서는 원 논문의 구조, 행렬 차원과 실험 결과를 다시 확인할 때 쓰는 자료 안내다. 본문과 표 위치는 arXiv v7 HTML을 기준으로 한다. 원기관 PDF.
원문에서 필요한 부분 찾기
| 질문 | 원문 위치 | 함께 확인할 내용 |
|---|---|---|
| 인코더와 디코더는 어떻게 연결되는가 | 그림 1, 3.1절 | 인코더 최종 출력, 디코더의 세 부분 층, 입력 한 칸 이동 |
| Q, K, V와 softmax는 무엇을 계산하는가 | 3.2절, 식 1, 각주 1 | 행별 정규화, 투영 차원, 내적 스케일의 가정 |
| 위치와 순서를 어떻게 넣는가 | 3.5절 | 사인과 코사인 공식, 학습 위치 벡터와의 비교 |
| 병렬화와 긴 문맥 비용은 어떻게 다른가 | 4절, 표 1 | 순차 연산 수, 정보 전달 경로, 시퀀스 길이의 제곱 항 |
| 기본 모델과 대형 모델의 차이는 무엇인가 | 5.2절, 표 2와 표 3 | 폭과 헤드 수, 학습 단계, 개발 세트와 시험 세트 |
| 학습 비용은 어떻게 추정했는가 | 6.1절, 각주 2 | 학습 시간, GPU 수, GPU별 지속 연산 성능 추정치 |
어텐션의 행렬 차원
기본 모델은 , 헤드 수 , 헤드별 다. 길이가 인 입력에서 셀프 어텐션의 헤드 하나는 다음과 같이 계산한다.
| 행렬 | 차원 | 역할 |
|---|---|---|
| 이전 단계의 토큰 표현 | ||
| 각각 | 헤드마다 학습하는 투영 | |
| 각각 | 질문, 비교 기준과 가져올 정보 | |
| 각각 | 위치 쌍의 점수와 행별 가중치 | |
| 헤드 하나의 출력 | ||
| 헤드 8개 연결 결과 | 출력 투영에 들어갈 표현 |
멀티헤드는 입력 전체를 서로 다른 행렬로 투영한다. 입력의 512개 성분을 고정된 64개씩 잘라 각각의 헤드에 주는 것으로 해석하지 않는다. 연결 결과에 출력 행렬을 곱한다.
스케일의 근거는 각주 1이다. Q와 K 성분이 독립이고 평균 0, 분산 1이라는 가정에서 내적의 분산이 가 되므로, 그 제곱근으로 나눠 점수의 규모를 조정한다.
교차 어텐션에서는 Q를 디코더 표현에서, K와 V를 인코더 최종 표현에서 만든다. 번역문 길이가 , 원문 길이가 이면 점수표는 이다. 디코더 셀프 어텐션은 미래 위치를 softmax 전에 로 가리고, 한 칸 이동한 정답 입력과 함께 사용한다. 이 구성으로 학습의 위치별 예측은 병렬화하고, 생성은 이전 출력을 입력에 추가하며 진행한다.
위치, FFN과 정규화
사인과 코사인 위치 인코딩은 다음과 같다.
위치 벡터는 임베딩과 같은 폭이며, 임베딩에 을 곱한 뒤 위치 벡터를 더한다. 3.5절은 학습되는 위치 벡터와 거의 같은 성능을 보고한다. 더 긴 시퀀스로의 외삽은 사인파를 선택한 기대이므로, 이 실험의 입증된 장문 성능 수치로 인용하지 않는다.
기본 모델의 FFN은 이며 중간에 ReLU를 적용한다. 같은 층의 모든 토큰 위치에서 가중치를 공유하고, 층 사이에는 서로 다른 가중치를 쓴다. 원 논문은 잔차 연결 뒤에 LayerNorm을 놓는 구조다. 드롭아웃을 생략한 식은 다.
모델 설정과 평가를 구분하기
| 항목 | 기본 모델 | 대형 모델 |
|---|---|---|
| 인코더 / 디코더 층 수 | 각각 6 | 각각 6 |
| 모델 폭 | 512 | 1024 |
| FFN 폭 | 2048 | 4096 |
| 헤드 수 | 8 | 16 |
| 매개변수 수 | 65M | 213M |
| 학습 단계 | 100K | 300K |
| P100 8개에서 학습 시간 | 약 12시간 | 약 3.5일 |
| EN-DE 시험 BLEU | 27.3 | 28.4 |
| EN-FR 시험 BLEU | 38.1 | 41.8 |
설정은 표 3, 시간은 5.2절, 시험 점수는 표 2의 newstest2014 결과다. 영어→프랑스어 대형 모델은 초록과 표 2에서 41.8, 6.1절 본문에서 41.0으로 표기가 다르다. 위 표는 초록과 표 2를 따른다.
헤드 수 비교는 표 3의 영어→독일어 개발 세트 newstest2013 결과다. 헤드 8개 25.8, 1개 24.9, 32개 25.4를 보고한다. ‘헤드 하나에서 0.9 하락’은 이 개발 세트 비교이며 위의 시험 점수와 직접 섞지 않는다. 표 3 실험은 체크포인트 평균을 쓰지 않았다.
학습률은 워밍업 4,000단계까지 선형으로 증가한 뒤 단계 수의 역제곱근으로 줄어든다. Adam의 설정은 , , 다. 기본 드롭아웃은 0.1이고 레이블 스무딩도 0.1이다. 논문은 레이블 스무딩으로 perplexity가 나빠져도 정확도와 BLEU는 좋아졌다고 보고한다.
BLEU의 정의는 Papineni 등의 원 논문에서 확인한다. 참조 번역과 후보 번역의 n-gram 일치 등을 바탕으로 하는 점수이므로, 백분율 정답률처럼 읽지 않는다.
계산 비용을 비교하는 범위
논문 표 1은 셀프 어텐션의 위치 간 계산 와 순환 층 , 순차 연산 수와 최대 정보 전달 경로를 비교한다. 어텐션의 전체 블록 비용에는 투영과 FFN도 들어가므로, 두 식의 비율은 전체 모델의 실측 속도 비율과 다르다. 합성곱의 경로 길이는 커널 구성에 달리며, 4절은 연속 커널과 팽창 합성곱을 나누어 설명한다.
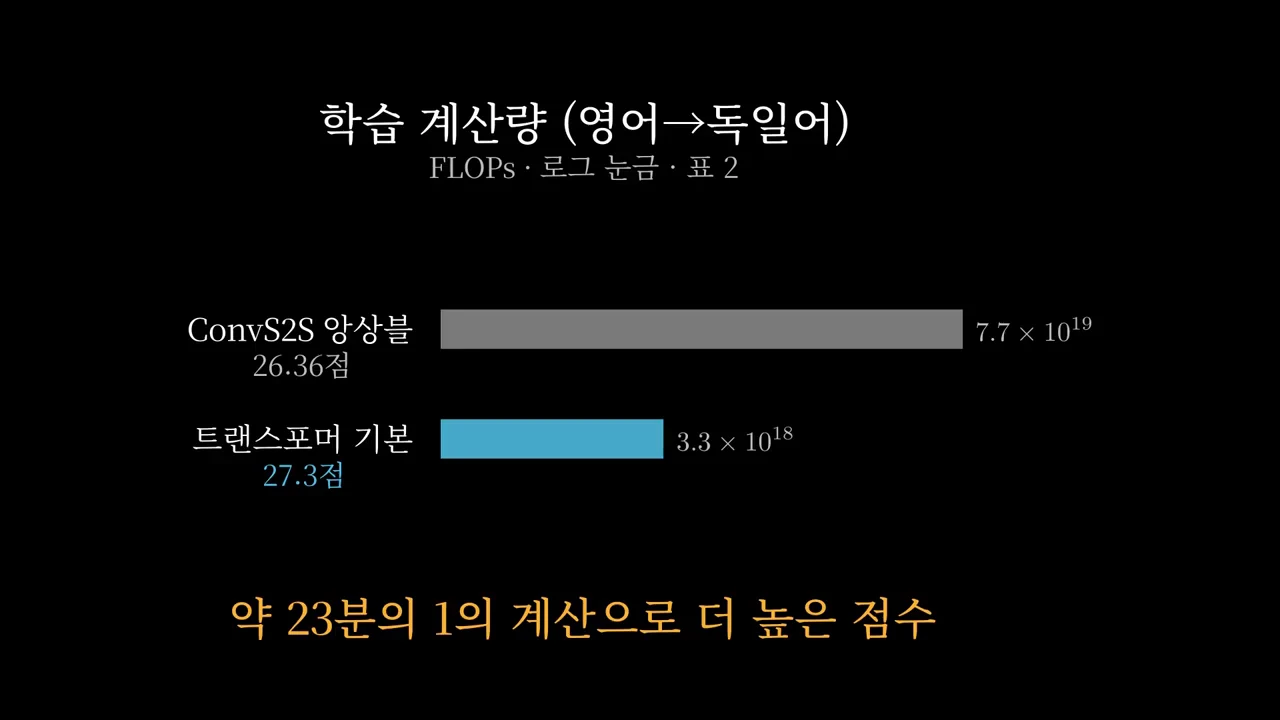
논문 표 2의 ConvS2S 앙상블과 기본 트랜스포머 비교를 영상에서 다시 그린 그림. FLOPs 막대는 로그 눈금이다. 뉴런한알, 11:56, 원 논문 표 2
표 2의 영어→독일어 ConvS2S 앙상블은 BLEU 26.36, 추정 학습 계산량 FLOPs다. 기본 트랜스포머는 BLEU 27.3, FLOPs다. 계산량 비율은 약 23.3배다.
6.1절은 학습 시간, GPU 수와 GPU의 지속 단정밀도 연산 성능 추정치를 곱해 학습 FLOPs를 추정했다고 설명한다. 이 수치는 두 구성의 학습 계산량 비교로 인용한다. 실측 추론 지연, 전력 소비나 동일 하드웨어의 실행시간 비율을 뜻하는 값으로 바꾸지 않는다.
선행 연구와 이후 구조
- Bahdanau, Cho, Bengio, 1409.0473: 2014년 제출된 RNN 기반 번역의 정렬과 어텐션 연구. 어텐션이 트랜스포머보다 앞서 쓰였다는 근거다.
- BERT, 1810.04805: 2018년 공개된 양방향 트랜스포머 인코더 기반 사전학습 연구.
- Improving Language Understanding by Generative Pre-Training: 2018년 초기 GPT의 디코더 기반 언어 모델 사전학습과 후속 과제 적용 연구.
원래 트랜스포머의 구조와 반복 깊이 모델을 비교하려면 루프 트랜스포머의 반복 깊이와 효율 비교 자료를 참고한다. 실제 생성 지연과 KV 캐시, 처리량은 AI 서빙의 지연과 용량을 읽는 법에서 이어서 다룬다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/llm-wiki/attention-is-all-you-need-transformer-source-guide/index.md'