 Readiz
64비트 CPU에서 64는 무엇의 크기일까
CPU의 데이터 폭과 주소 폭을 분리해 6502의 주소 조립, Pentium Pro의 PAE, 현대 CPU의 RAM 한계를 이해한다.
글 관리 · 공개 범위64비트 CPU에서 64는 무엇의 크기일까. 흔히 “32비트는 메모리를 4GB까지만 쓰고, 64비트는 그보다 많이 쓴다”고 설명한다. 익숙한 PC 환경을 요약할 때는 편한 말이다. 그런데 이 문장을 CPU 자체의 정의로 외우면, 오래된 8비트 컴퓨터부터 설명이 안 된다. 8비트로는 256가지 값만 표현하는데, MOS 6502는 어떻게 64KiB의 주소 공간을 다뤘을까?
핵심은 데이터를 계산하는 폭, 메모리 위치를 나타내는 주소의 폭, 실제로 설치할 수 있는 RAM 용량을 따로 보는 것이다. Core Dumped의 영상은 이 차이를 작은 CPU의 동작부터 설명한다. 이 구분을 이해하면 32비트 CPU가 4GiB를 넘는 물리 메모리에 접근하는 이유도, 64비트 CPU의 사양표에 최대 메모리가 256GB로 적히는 이유도 같은 원리로 이어진다.
4GiB라는 계산에서 빠진 전제
메모리를 길게 늘어선 바이트 칸으로 생각해보자. 각 칸에는 8비트 데이터가 들어가고, 주소는 그중 어느 칸을 읽거나 쓸지 지정하는 번호다. 실제 RAM 안에서는 주소를 해석하는 회로가 셀을 선택하고 데이터를 읽지만, 프로그램에 보이는 기본 모델은 이 바이트 배열이다. 한 주소가 1바이트를 가리키는 방식을 바이트 주소 지정이라고 한다.
여기서 주소가 비트라면 서로 다른 주소는 개다. 따라서 주소 공간의 크기는 다음과 같이 계산된다.
32비트 주소라면 0부터 까지, 모두 4,294,967,296개의 바이트를 식별한다. 정확히 4GiB다. 최대 주소의 값과 주소 개수에는 1 차이가 있다는 점도 중요하다. 0xFFFFFFFF는 마지막 주소이며, 0번지까지 포함한 공간의 크기가 바이트다.
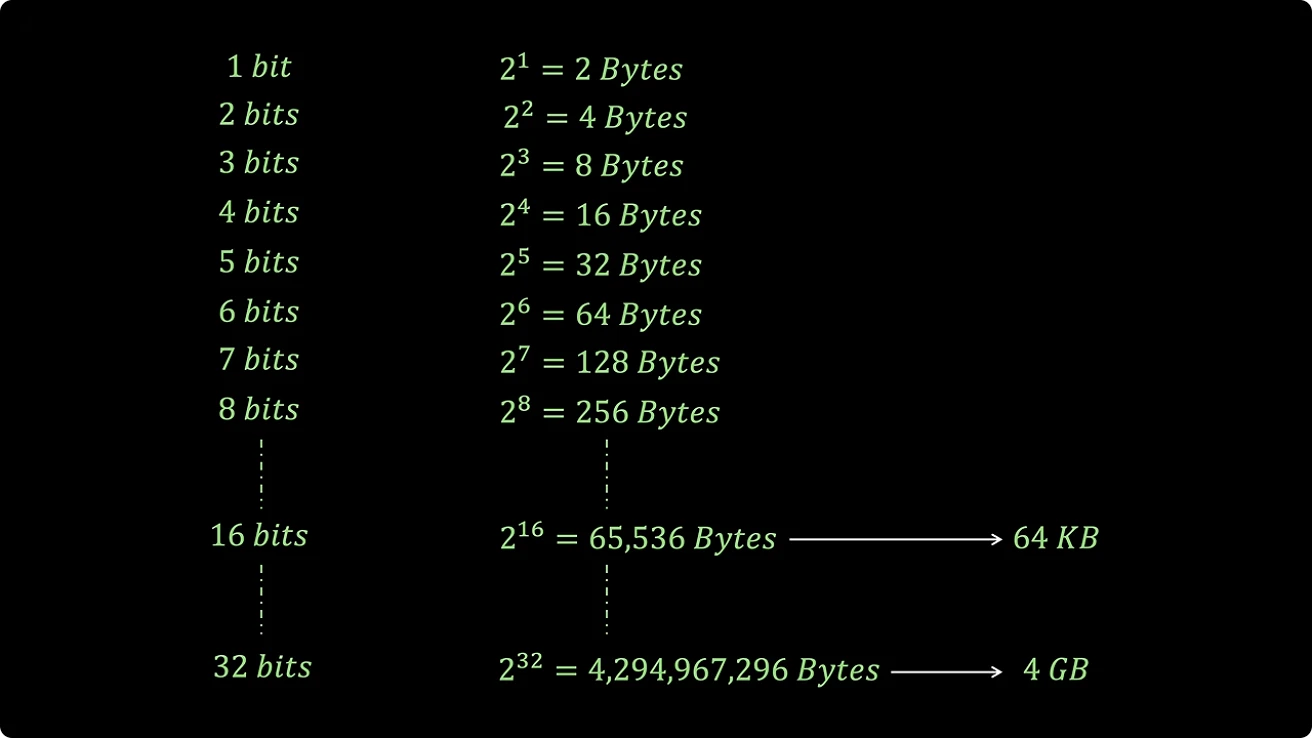
주소의 비트 수가 하나 늘 때마다 공간은 두 배로 증가. 영상의 KB·GB는 여기서는 KiB·GiB에 해당한다. Core Dumped, 2:15
계산은 맞다. 문제는 에 어떤 숫자를 넣었느냐다. 32비트 주소를 사용한다는 전제가 있을 때 4GiB가 나온다. CPU를 32비트라고 부른다는 사실만으로 모든 주소까지 32비트여야 하는 것은 아니다.
이 글에서는 2의 거듭제곱으로 계산한 용량에 KiB·GiB·TiB·PiB·EiB를 쓴다. 제조사 사양을 인용할 때는 원문에 적힌 GB·TB 표기를 유지한다.
CPU의 비트 수는 계산 단위에서 출발한다
영상에서 설명하는 CPU의 비트 수는 기본 정수 데이터를 다루는 폭이다. 범용 레지스터는 연산할 값과 결과를 잠시 보관하고, ALU는 그 값으로 덧셈이나 논리 연산을 수행한다. 8비트 CPU라면 이런 기본 데이터 경로가 8비트인 구조를 떠올리면 된다. 이것을 CPU 안의 모든 회로와 레지스터, 모든 명령어가 똑같이 8비트라는 뜻으로 확대하면 안 된다.
영상의 19 + 16 예가 직관적이다. 19와 16은 각각 이진수 10011, 10000이다. 두 값 모두 5비트가 필요하므로 8비트 레지스터에는 들어가지만 4비트 레지스터 하나에는 들어가지 않는다.
그렇다고 4비트 CPU에서 이 덧셈을 못 하는 것은 아니다. 큰 수를 여러 조각으로 나누면 된다.
19 = 0001 0011
16 = 0001 0000

아래쪽 4비트: 0011 + 0000 = 0011
위쪽   4비트: 0001 + 0001 = 0010
합친 결과:   0010 0011 = 35
이 예에서는 아래쪽 덧셈의 자리올림이 0이다. 일반적인 여러 자리 덧셈에서는 아래 조각에서 생긴 carry를 다음 조각에 전달해야 한다. 종이에 긴 덧셈을 하는 것과 같은 원리다. 더 넓은 레지스터는 이 작업을 더 큰 덩어리로 처리하게 해준다. 위 예가 보여주는 것은 필요한 연산 단계의 차이이며, CPU 비트 수가 두 배면 모든 프로그램이 두 배 빨라진다는 성능 공식은 아니다.
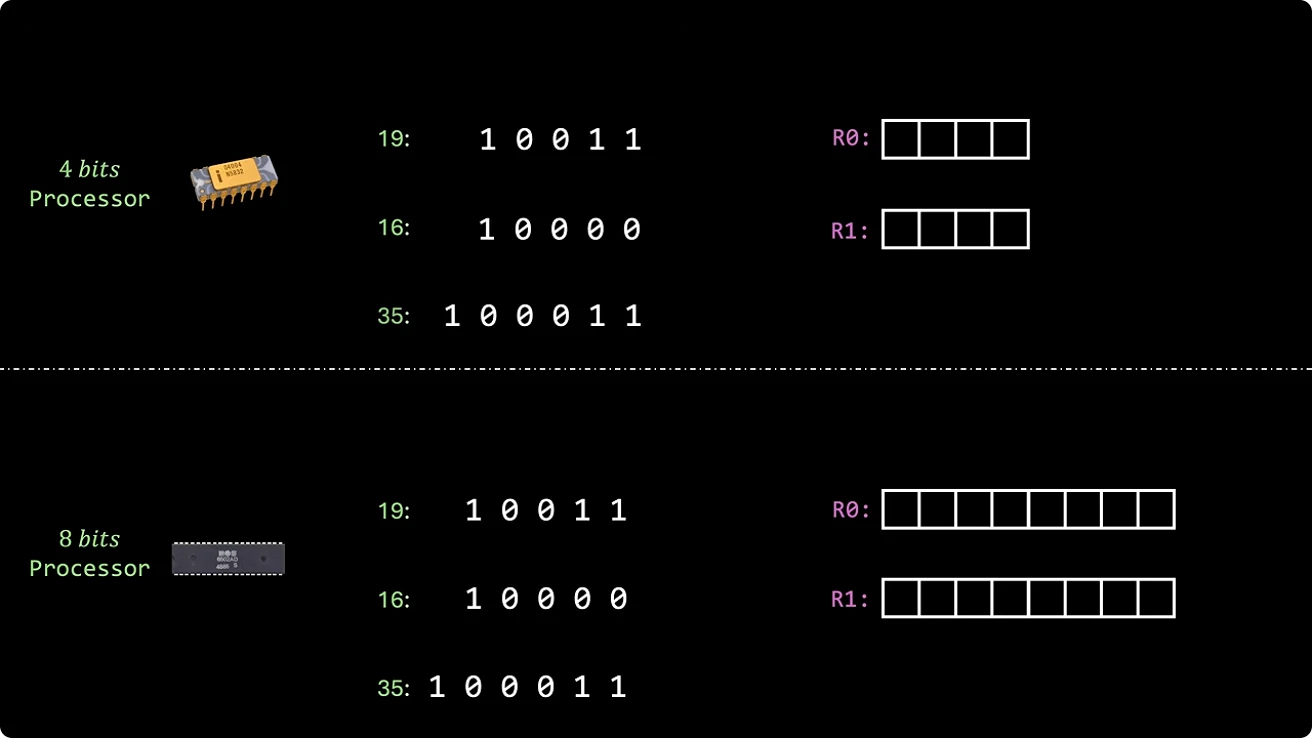
같은 정수 덧셈을 다른 폭의 레지스터로 처리하는 예. Core Dumped, 4:30
이 설명은 주소에도 그대로 적용된다. 한 번에 다루는 데이터보다 긴 숫자를 여러 조각으로 만들 수 있다면, 주소를 만드는 회로 역시 범용 레지스터보다 넓게 설계할 수 있다.
주소를 보내는 길과 데이터를 보내는 길
단순한 CPU와 메모리 연결 그림에는 두 종류의 통로가 나온다. 주소 버스는 “어디를 읽을 것인가”를 전달하고, 데이터 버스는 “그곳에 무엇이 들어 있는가”를 전달한다. 16비트 주소로 65,536개 위치 중 하나를 선택한 뒤, 그 위치에서 8비트 데이터를 받아오는 구조는 전혀 모순되지 않는다.
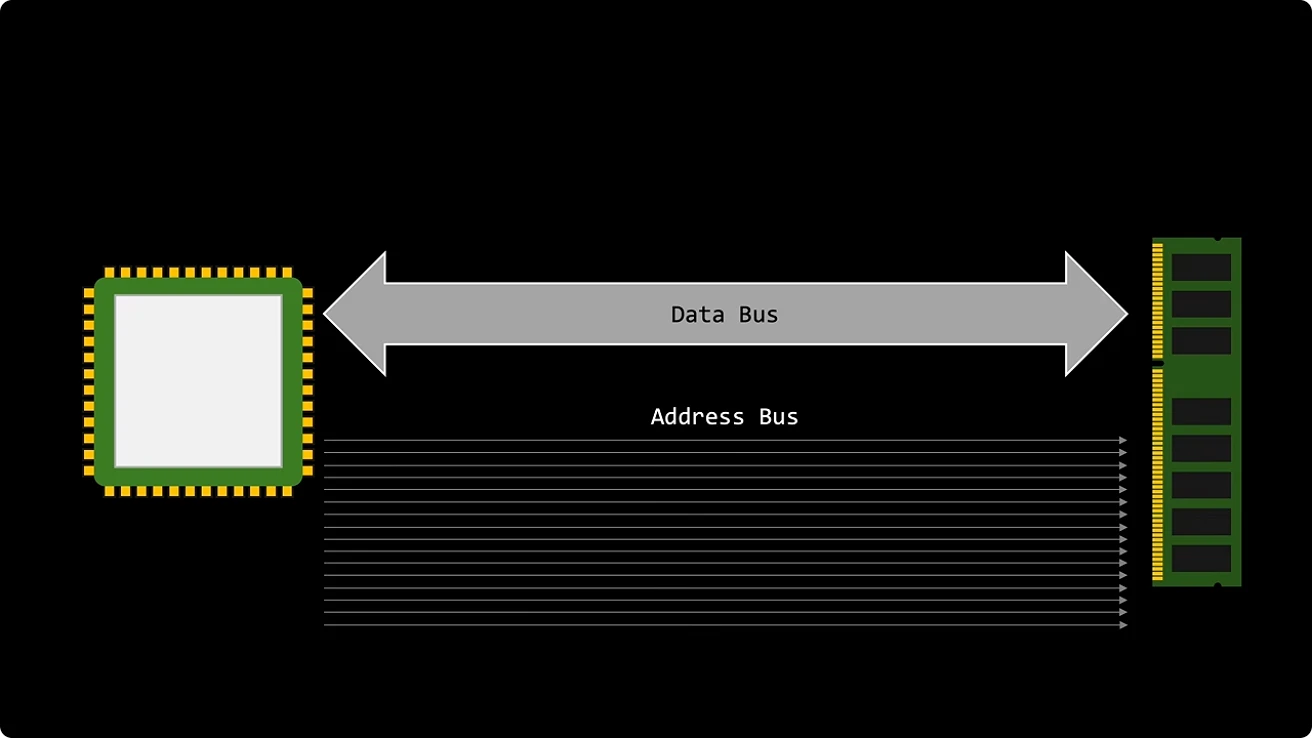
위치 선택과 데이터 전송을 분리한 개념도. Core Dumped, 5:50
CPU 내부의 레지스터도 용도별로 폭이 다를 수 있다. 프로그램 카운터는 다음에 가져올 명령어의 위치를 기억한다. 이 값이 넓은 주소 공간을 가리켜야 한다면, 데이터를 계산하는 누산기보다 크게 만들면 된다.
6502 계열의 W65C02S 공식 자료가 좋은 예다. 누산기 A와 인덱스 레지스터 X·Y는 8비트인 반면, 프로그램 카운터 PC와 주소 버스는 16비트다. WDC 데이터시트의 5쪽 특징 목록과 8쪽 프로그래밍 모델에서 확인할 수 있다. W65C02S는 영상의 초기 MOS 6502와 같은 모델은 아니지만, 이 계열의 데이터 폭과 주소 폭을 분리해서 읽는 데 명확한 원자료다.
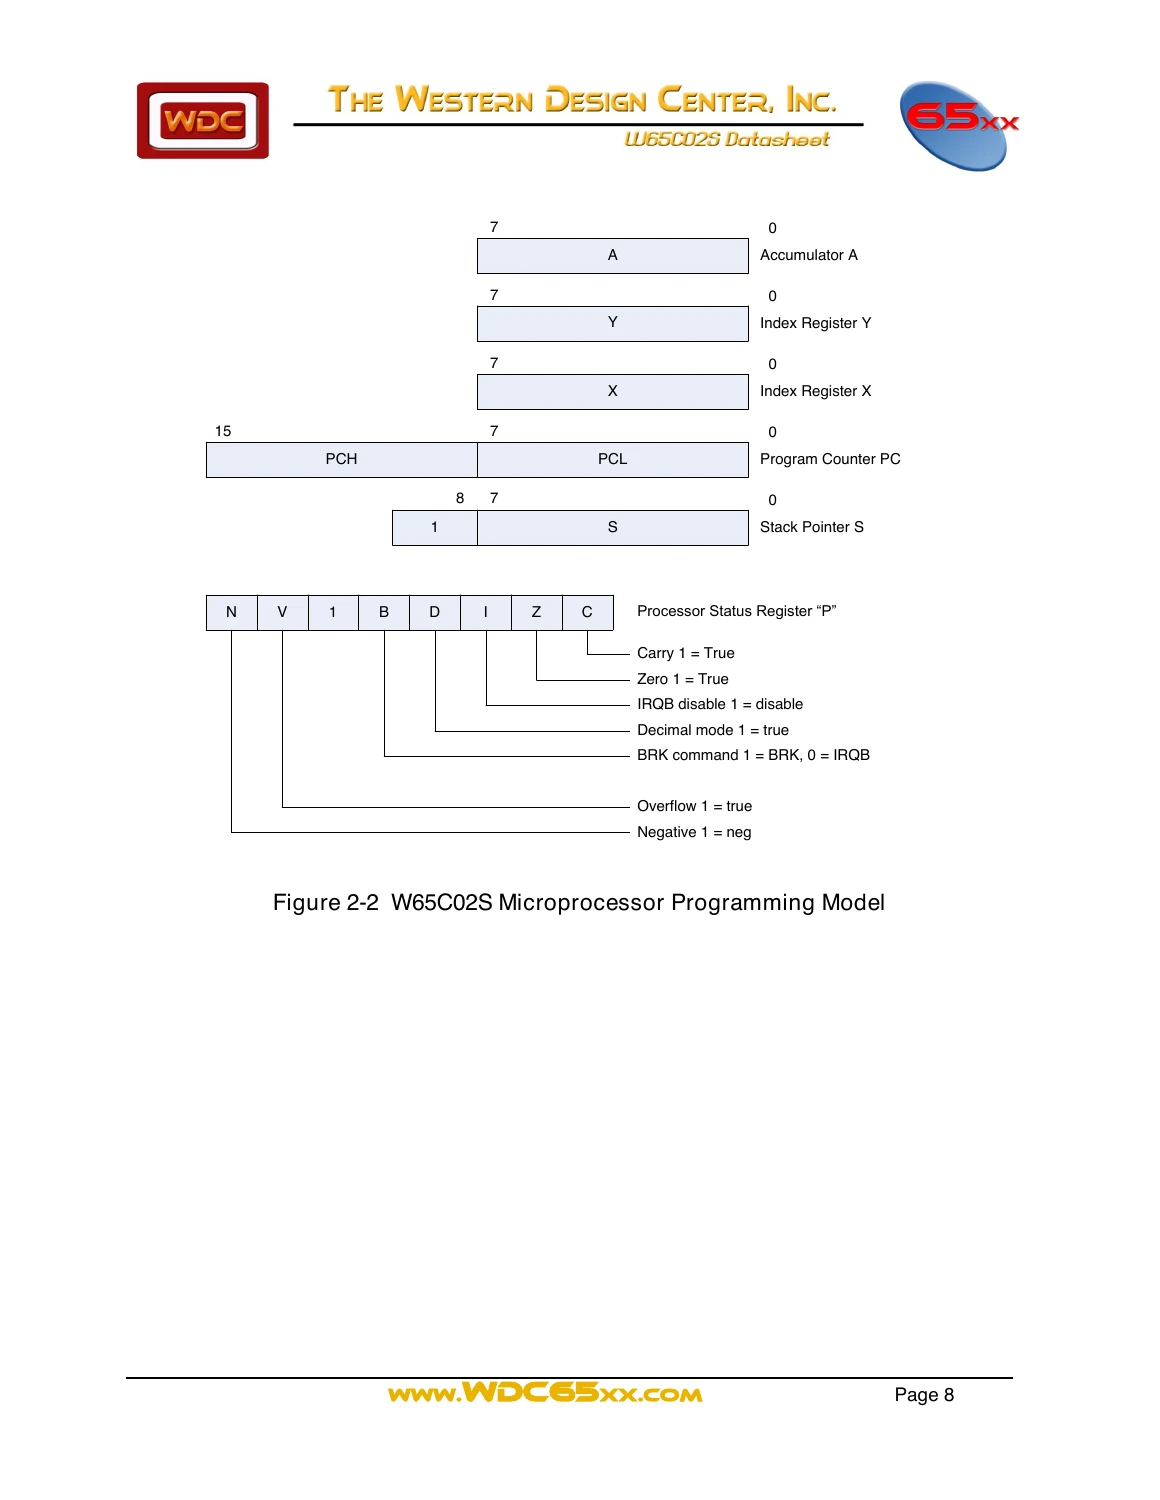
A·X·Y와 PC의 폭이 다른 실제 프로그래밍 모델. WDC, W65C02S Datasheet, 8쪽 Figure 2-2
8비트 값 두 개로 16비트 주소 만들기
그럼 작은 레지스터에 담긴 값으로 긴 주소는 어떻게 만들까. 영상은 16비트 주소 레지스터를 상위 8비트 H와 하위 8비트 L로 나누는 가상의 CPU를 사용한다.
예를 들어 하위 바이트가 0x35, 상위 바이트가 0x0D라면 합친 주소는 0x0D35다. 상위 값을 8비트 왼쪽으로 옮긴 뒤 하위 값을 붙이는 셈이다.
영상의 과정을 동작 중심으로 다시 적으면 다음과 같다. 실제 6502 명령어 문법이 아닌 설명용 의사 코드다.
low  = memory[addr]
high = memory[addr + 1]
address_register.low  = low
address_register.high = high
value = memory[address_register]
먼저 주소를 구성하는 두 바이트를 읽는다. 두 값을 주소 레지스터의 각 절반에 넣은 뒤, 완성된 주소가 가리키는 곳에서 데이터를 읽는다. 마지막으로 읽는 데이터가 여전히 1바이트여도 주소는 16비트일 수 있다.
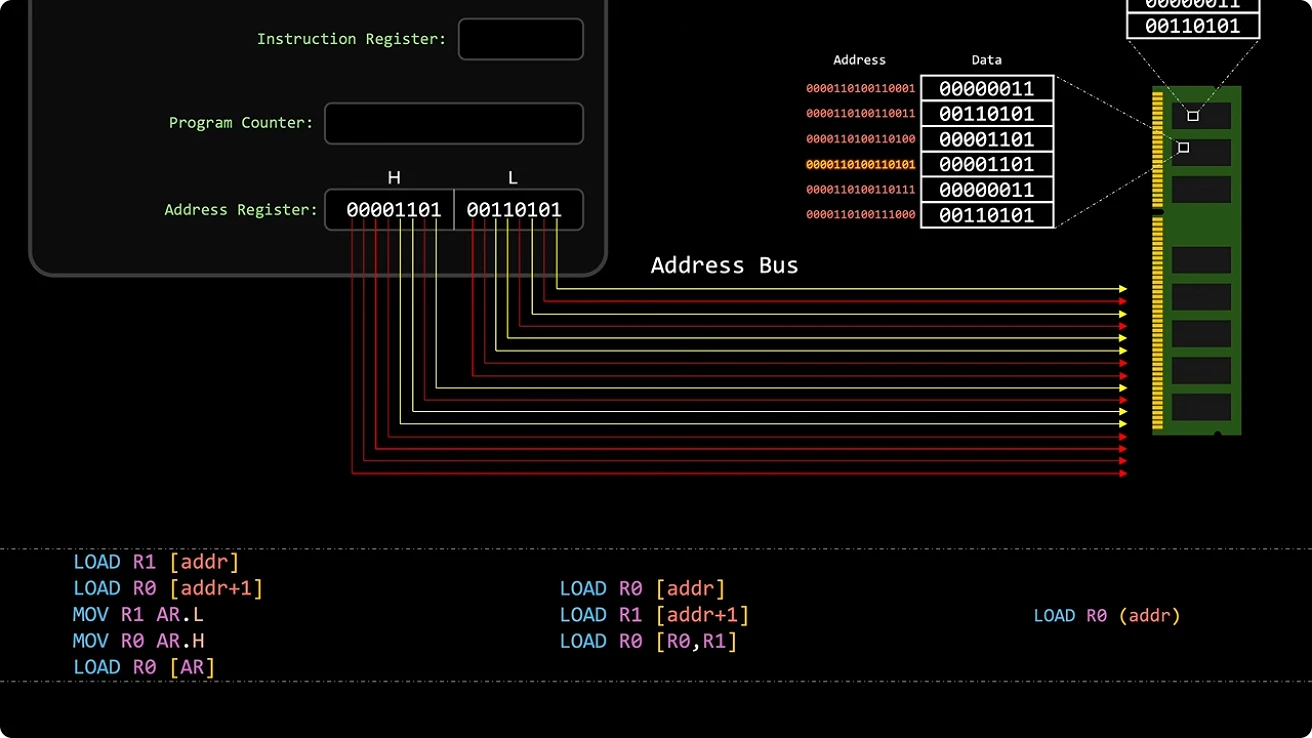
같은 주소 생성 과정을 여러 명령으로 드러내거나 명령어 내부에 포함하는 방식. Core Dumped, 7:50
명령어 집합은 이 과정을 다르게 표현할 수 있다. 두 레지스터를 한 쌍으로 받아 주소를 만드는 명령을 제공할 수도 있고, 메모리에 저장된 주소를 따라가는 간접 주소 지정 명령으로 묶을 수도 있다. 한 줄로 적힌 명령이 내부에서도 한 번의 데이터 이동으로 끝난다는 뜻은 아니다. 주소 조립과 메모리 읽기의 여러 단계를 하드웨어가 맡을 수 있다는 의미다.
주소 레지스터를 프로그래머가 직접 조작하게 노출하는지도 아키텍처마다 다르다. 영상의 H·L 모델은 가능한 작동 원리를 설명하는 장치이며, 모든 CPU가 동일한 이름의 레지스터를 제공한다는 설명은 아니다.
명령어 길이도 CPU의 비트 수와 별개다
8비트 CPU라면 명령어도 반드시 1바이트여야 할까? 6502의 명령어를 보면 답이 바로 나온다. 명령어는 무슨 일을 할지 나타내는 opcode와, 필요한 경우 값이나 주소를 나타내는 추가 바이트로 이루어진다.
영상의 예에서 5와 3을 더해 특정 메모리 위치에 저장하는 부분은 다음과 같다. 여기서 #$05는 값 5 자체, $0200은 주소를 의미한다.
LDA #$05    ; A에 5를 넣는다
CLC         ; 덧셈에 쓸 carry를 0으로 만든다
ADC #$03    ; A에 3과 carry를 더한다
STA $0200   ; 결과 8을 주소 0x0200에 저장한다
이진 정수 모드라는 전제에서 마지막 저장 값은 8이다. 길이는 각각 2, 1, 2, 3바이트다. CLC는 무슨 동작인지 알리는 1바이트면 충분하고, LDA #$05는 opcode 뒤에 값 5를 붙인다. STA $0200은 opcode 뒤에 16비트 주소가 필요하므로 총 3바이트다.
| 명령어 | 기계어 바이트, 16진수 | 길이 | 추가 바이트의 의미 |
|---|---|---|---|
LDA #$05 | A9 05 | 2바이트 | 즉시값 5 |
CLC | 18 | 1바이트 | 없음 |
ADC #$03 | 69 03 | 2바이트 | 즉시값 3 |
STA $0200 | 8D 00 02 | 3바이트 | 주소 0x0200 |
00 02는 주소의 낮은 바이트부터 저장하는 순서다. 이 바이트들을 읽어 0x0200이라는 주소를 복원한다. WDC 문서의 절대 주소 지정 설명도 opcode 다음 두 바이트가 16비트 주소를 만든다고 명시한다. 이처럼 데이터 연산 폭이 8비트인 CPU도 여러 바이트의 명령어를 읽어 16비트 주소를 만들 수 있다.
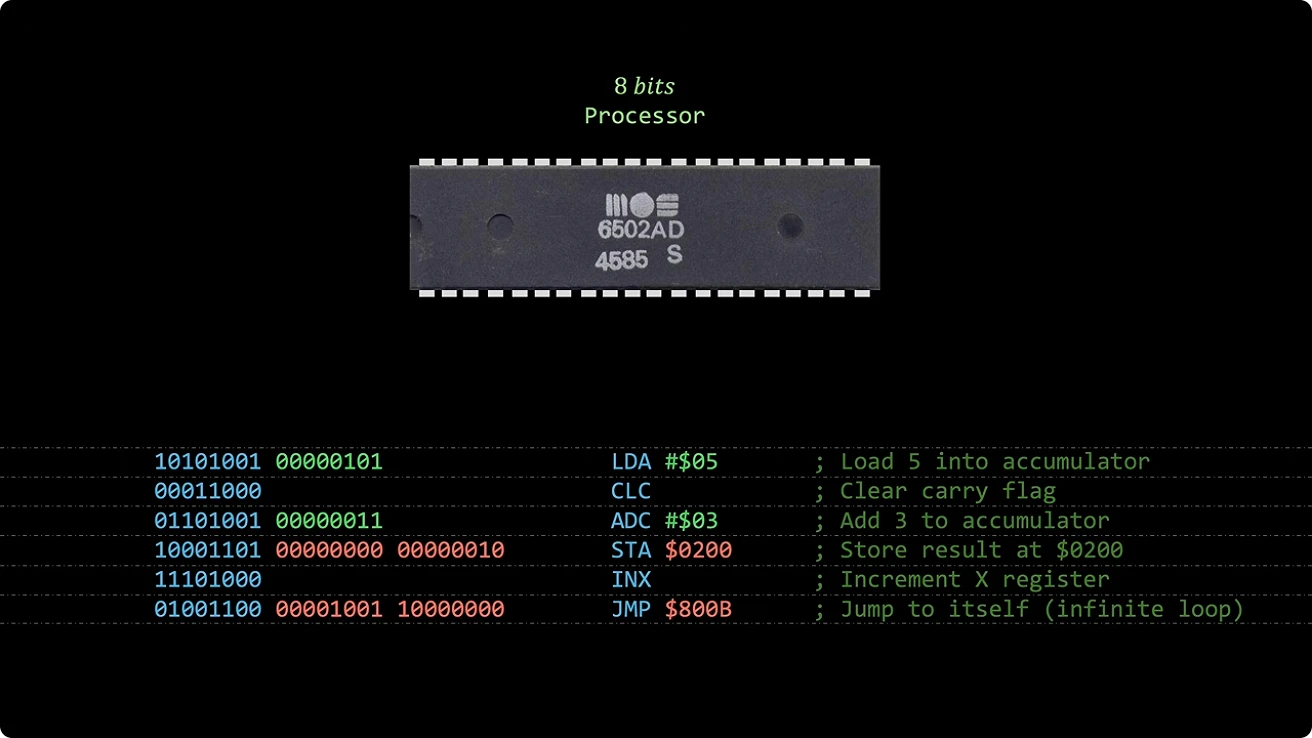
명령의 기능에 따라 달라지는 인코딩 길이. 화면 마지막 JMP 행의 4C 09 80은 JMP $8009에 해당하며, $800B라면 4C 0B 80이어야 한다. Core Dumped, 9:07
32비트 CPU가 64GiB에 접근할 수 있었던 이유
영상의 역사적 반례는 이 구조를 확인하는 사례다. 8비트 MOS 6502는 16비트 주소를 사용한다. 32비트 Pentium Pro는 PAE, 즉 물리 주소 확장을 통해 36비트 물리 주소 공간을 지원한다. 32에서 36으로 주소 비트가 네 개 늘면 공간은 배가 된다. 4GiB에서 64GiB로 늘어나는 계산이다.
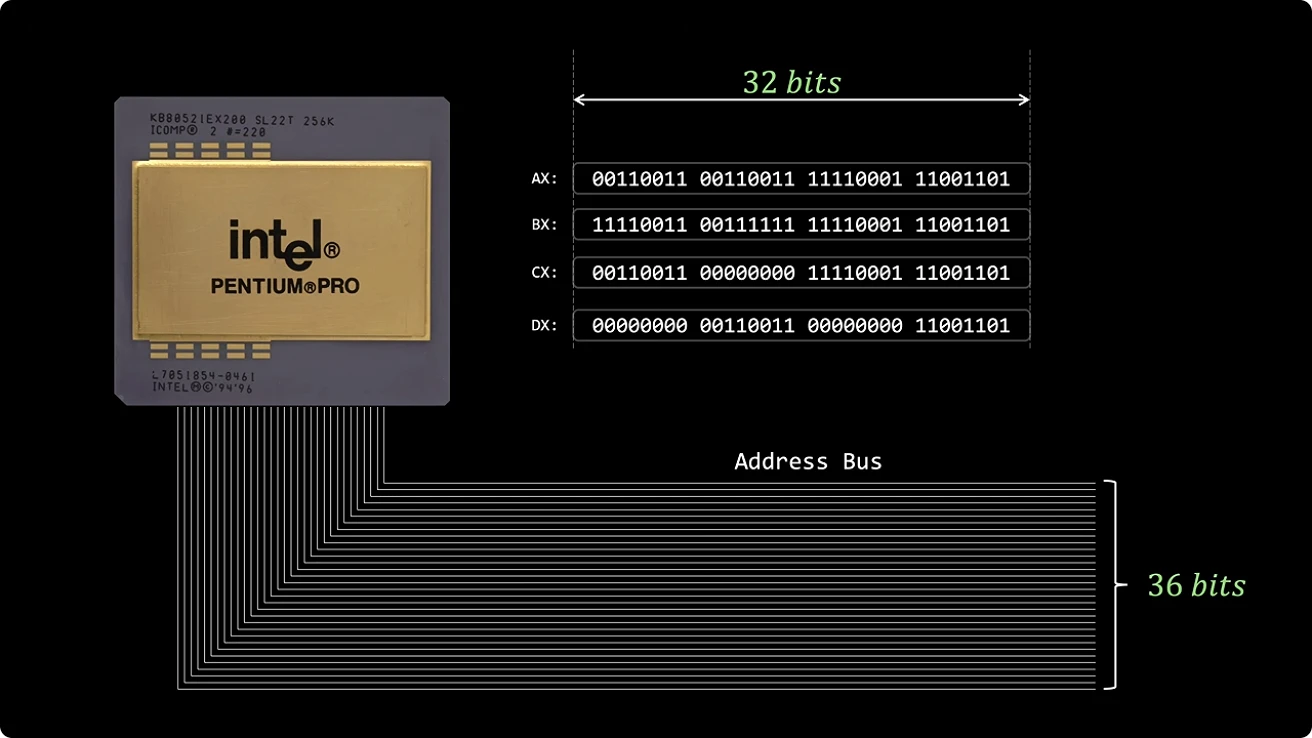
데이터 폭과 물리 주소 폭의 차이. 그림의 AX·BX 등은 개념 표기이며 실제 32비트 레지스터 이름은 EAX·EBX 등이다. Core Dumped, 10:07
Intel SDM Volume 3A의 3.3절은 Pentium Pro부터 물리 주소 공간을 바이트로 확장했다고 설명한다. 여기서 말하는 것은 CPU의 주소 지정 능력이다. 어떤 메인보드와 운영체제를 쓰든 실제로 64GiB를 설치할 수 있다는 보장은 아니다.
이 대목에서 가상 주소와 물리 주소를 분리해야 한다. 프로그램이 사용하는 가상 주소는 운영체제가 관리하는 페이지 테이블을 거쳐 물리 주소로 변환된다. PAE에서는 프로그램의 32비트 주소를 유지하면서 변환 결과가 더 넓은 물리 공간을 가리키도록 할 수 있다. 작은 지도에 적힌 번호를 큰 창고의 실제 위치와 연결하는 셈이다.
따라서 PAE를 켰다고 한 32비트 프로그램의 평평한 가상 주소 공간이 자동으로 64GiB가 되지는 않는다. Microsoft의 PAE 설명도 프로세스의 가상 주소 공간과 시스템이 접근하는 물리 메모리의 확장을 구분한다. 실제 사용자 영역에는 운영체제의 분할·제약이 추가된다. “32비트에서 4GiB 제한을 봤다”는 경험과 “32비트 CPU가 더 큰 물리 메모리를 다룬다”는 설명은 이렇게 함께 성립한다.
영상은 더 작은 4비트 Intel 4004도 소개한다. 이 사례에는 바로잡아 읽을 부분이 있다. 영상의 3:38 화면은 4 KB RAM이라고 표시하지만, Intel의 4004 원본 데이터시트 보존본은 4K개의 8비트 프로그램 명령어 공간과 5,120비트의 데이터 RAM을 구분한다. 프로그램 쪽이 4KiB이며 데이터 RAM은 640바이트다. 서로 다른 메모리를 하나의 RAM 수치로 합치면 안 된다. 4비트 데이터 경로와 더 넓은 프로그램 주소를 가진다는 핵심 사례로 읽는 것이 정확하다.
64비트가 되자 오히려 주소가 더 좁아졌다
주소를 64비트 전부로 구성하고 각 주소가 1바이트를 가리킨다고 가정하면 공간은 다음 크기다.
이만큼의 정수 값을 다룰 수 있는 것과 이만큼의 물리 주소 공간을 실제 하드웨어에 구현하는 것은 별도 선택이다. 현대 CPU는 기본 64비트 정수 연산을 지원하면서도 물리 주소에는 더 적은 비트를 구현한다. 과거에는 계산 폭보다 넓은 주소가 필요했고, 지금은 64비트 전체보다 작은 주소 공간으로도 제품의 요구를 충족하는 경우가 많다.
영상은 i5-9600K의 최대 메모리 128GB 사양에서 출발해, Core Ultra 9 285K와 Xeon 사례를 비교한다. i5-9600K의 128GB는 Intel 제품 비교표, 285K의 256GB와 두 메모리 채널은 Intel 제품 사양에서도 확인된다.
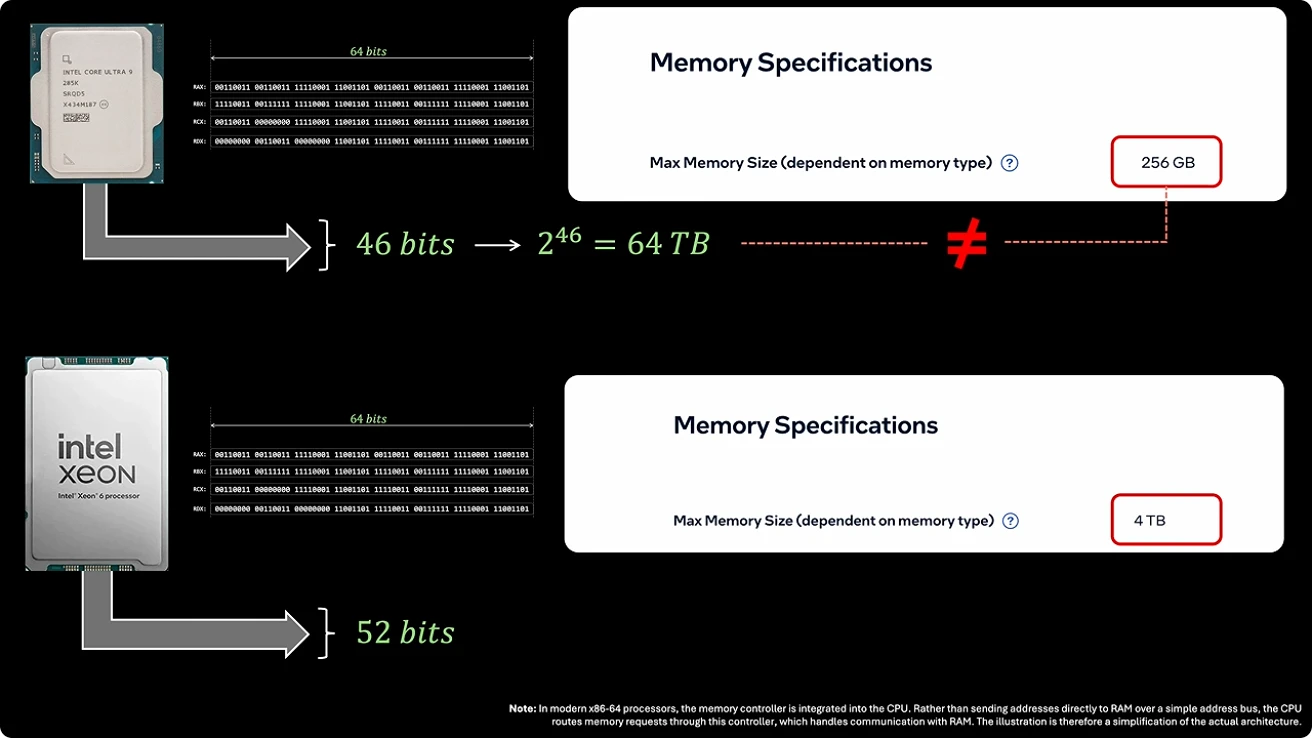
영상이 제시한 285K의 46비트 주소와 256GB 메모리 사양 비교. 아래 Xeon의 52비트·4TB는 영상의 사례이며 Xeon 6 전체의 공통 사양을 뜻하지 않는다. 그림의 주소 버스는 통합 메모리 컨트롤러를 단순화한 표현이다. Core Dumped, 12:39
46비트 바이트 주소 공간은 64TiB, 52비트는 4PiB다. 그러나 사양표의 최대 RAM은 메모리 컨트롤러, 지원하는 모듈 구성, 보드 설계 같은 제품 조건의 결과다. 주소를 붙일 수 있는 공간이 크다고 그 공간 전부를 RAM으로 채울 수 있는 것은 아니다. 물리 주소 공간에는 메모리 매핑 I/O 같은 장치 영역도 들어간다.
숫자가 크다고 의미까지 같아지지는 않는다. 64-bit는 기본 데이터 처리 구조를 읽는 정보이고, 물리 주소 비트는 주소 지정 범위를 읽는 정보이며, Max Memory Size는 제품 구성의 메모리 지원 범위를 읽는 정보다. RAM 증설 가능성을 판단할 때는 마지막 정보와 메인보드·운영체제 조건이 직접적인 기준이 된다.
내 시스템에서는 무엇을 확인하면 될까
영상 마지막에는 Linux의 lscpu가 나온다. Linux 환경에서 다음처럼 실행하면 주소 폭을 볼 수 있다. 출력 언어 때문에 필터가 비지 않도록 LC_ALL=C를 덧붙였다.
LC_ALL=C lscpu | grep 'Address sizes'영상의 Ryzen 9 9950X3D 시연에는 다음 값이 표시된다. 이 글을 작성한 환경에서 직접 측정한 수치가 아니라 영상 속 결과다.
Address sizes: 48 bits physical, 48 bits virtual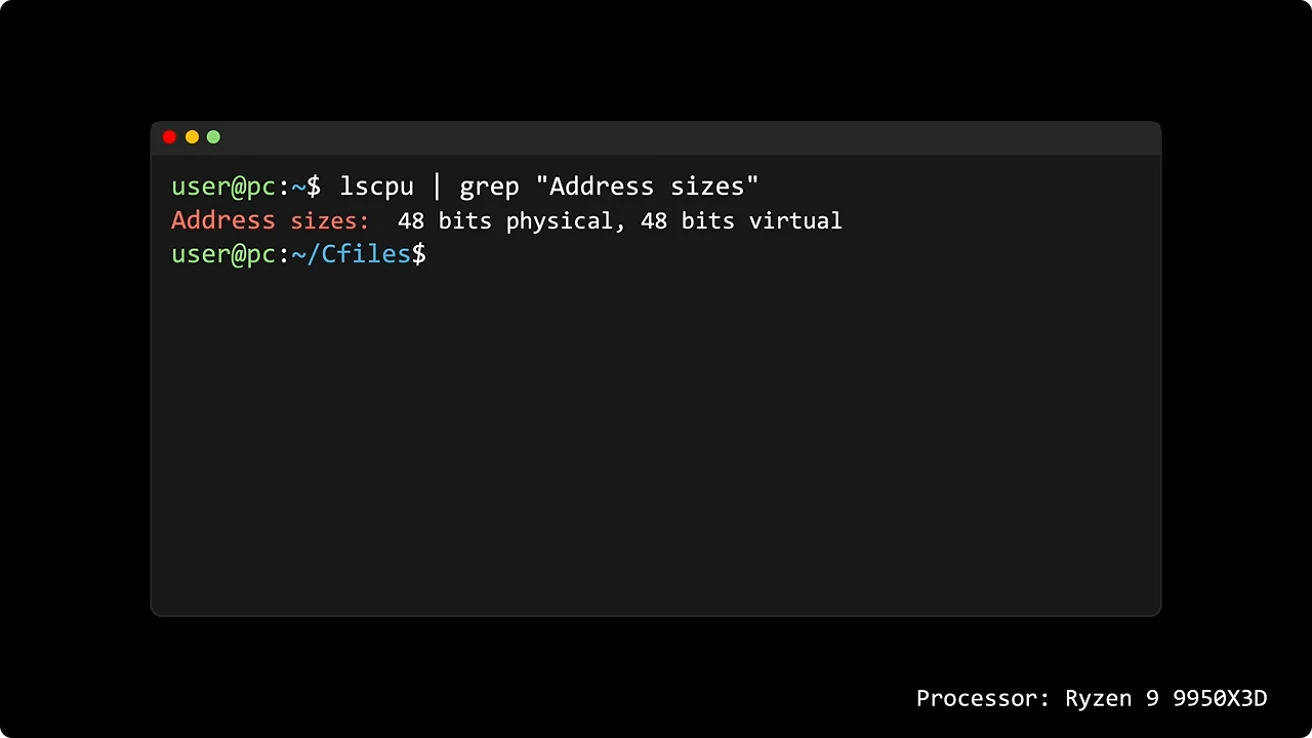
Ryzen 9 9950X3D로 표시된 시연의 주소 폭. Core Dumped, 13:01
physical과 virtual이 서로 다르게 나와도 이상하지 않다. 프로그램의 주소를 메모리 쪽 주소로 변환하므로 두 공간의 폭을 따로 설계할 수 있다. 이 출력은 설치된 RAM 용량을 측정한 것도 아니다. 가상 머신에서는 게스트에 노출된 CPU 정보를 보게 된다는 점도 lscpu 설명서의 범위에 포함된다.
영상이 후속 주제로 남긴 가상 주소 이야기는 한 가지만 더 짚어두면 좋다. x86-64의 4단계 페이징은 48비트, 5단계 페이징은 57비트 선형 주소를 다룬다. Linux 문서에서 말하는 56비트 사용자 공간은 이 전체 공간 중 사용자 쪽 범위를 설명하는 값이다. 영상 말미의 Xeon 화면에 적힌 56 bits virtual을 x86의 일반적인 주소 폭 정의로 옮기면 이 둘이 섞인다. Intel SDM과 Linux의 5단계 페이징 문서는 전체 주소 폭과 사용자 공간을 구분해 읽어야 한다.
64비트라는 이름 하나로 RAM 용량을 계산하면 중간의 하드웨어와 운영체제가 사라진다. 작은 데이터를 여러 단계로 계산하는 방법, 긴 주소를 조립하는 방법, 가상 주소를 물리 주소로 변환하는 방법이 그 사이에 있다. CPU의 비트 수는 데이터 처리의 출발점이고, 메모리 한계는 주소 변환과 실제 제품 구성을 따라가야 이해할 수 있다. 이 구분을 잡아두는 쪽이 “32비트는 4GB”라는 한 문장을 외우는 것보다 오래 쓸 수 있는 지식이다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/records/cpu-bits-register-address-memory/index.md'