 Readiz
LLM 서빙의 성능은 요청과 메모리를 다루는 방식에서 갈린다
KV 캐시, 요청 스케줄링, speculative decoding과 GPU 커널이 LLM 서빙의 지연과 처리량에 미치는 영향을 설명한다.
글 관리 · 공개 범위LLM 서빙 서버는 여러 사용자의 요청이 하나의 모델과 GPU 메모리를 함께 쓰는 방식을 관리한다. 들어온 요청을 큐에 두고, 현재 GPU가 처리할 묶음을 고른다. 모델은 각 요청의 입력과 이전에 계산해 둔 상태를 읽어 다음 토큰의 점수를 만든다. 샘플러가 그 점수에서 토큰을 고르면, 서버는 토큰을 사용자에게 보내고 그 상태를 다음 계산에 이어 쓴다.
Jia-Bin Huang의 「How LLM Serving Actually Works」(2026년 11월 2일)는 이 과정을 요청 큐, 스케줄러, 모델과 KV 캐시, 샘플러, 스트리밍으로 나누어 설명한다. 이 흐름을 따라가면 서빙의 성능 문제가 어디에 생기는지 보인다. GPU 계산만 빨라져도 대기열이 길거나, 같은 접두부를 매번 다시 계산하거나, 요청을 담을 메모리가 부족하면 사용자가 받는 응답은 늦어진다. 모델을 여러 요청이 함께 쓰도록 묶으면서도 각 요청이 기다리는 시간을 지키는 설계가 필요하다.
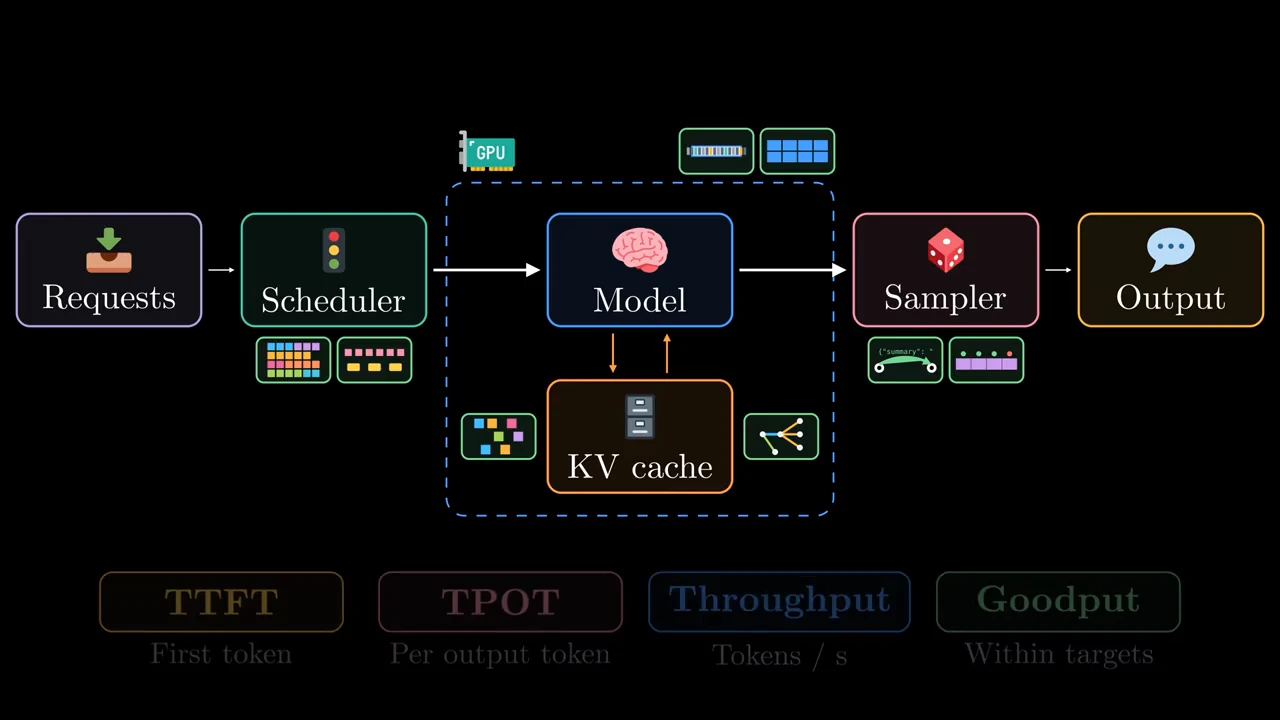
요청을 묶는 스케줄러와 모델의 KV 캐시, 다음 토큰을 고르는 샘플러. Jia-Bin Huang, 41:30
자기회귀 생성은 KV 캐시를 길게 만든다
일반적인 decoder-only LLM은 토큰을 한 번에 하나씩 만든다. 현재까지의 토큰으로 다음 토큰을 예측하고, 선택한 토큰을 문맥에 붙여 다시 실행한다. 완성된 응답이 나오기까지 이 과정을 반복한다.
어텐션의 각 층은 입력 토큰의 표현을 변환해 Query, Key, Value를 만든다. Query는 현재 위치가 찾는 정보, Key는 각 위치를 비교할 기준, Value는 그 위치에서 가져올 정보에 해당한다. 현재 Query와 과거 Key의 점수로 가중치를 정하고, 그 가중치로 Value를 합쳐 문맥 정보를 얻는다. 다음 토큰을 처리할 때 과거 토큰의 Key와 Value는 바뀌지 않는다. 인과적 어텐션에서는 과거 토큰이 미래 토큰을 보지 않으므로, 과거 위치에서 만든 K와 V를 다음 스텝에 다시 쓸 수 있다. 이 저장 공간을 KV 캐시라고 한다. 매번 문장 처음부터 모든 K와 V를 다시 만들지 않게 해 주지만, 새 토큰이 길어진 문맥의 캐시를 읽는 비용까지 없애 주지는 않는다.
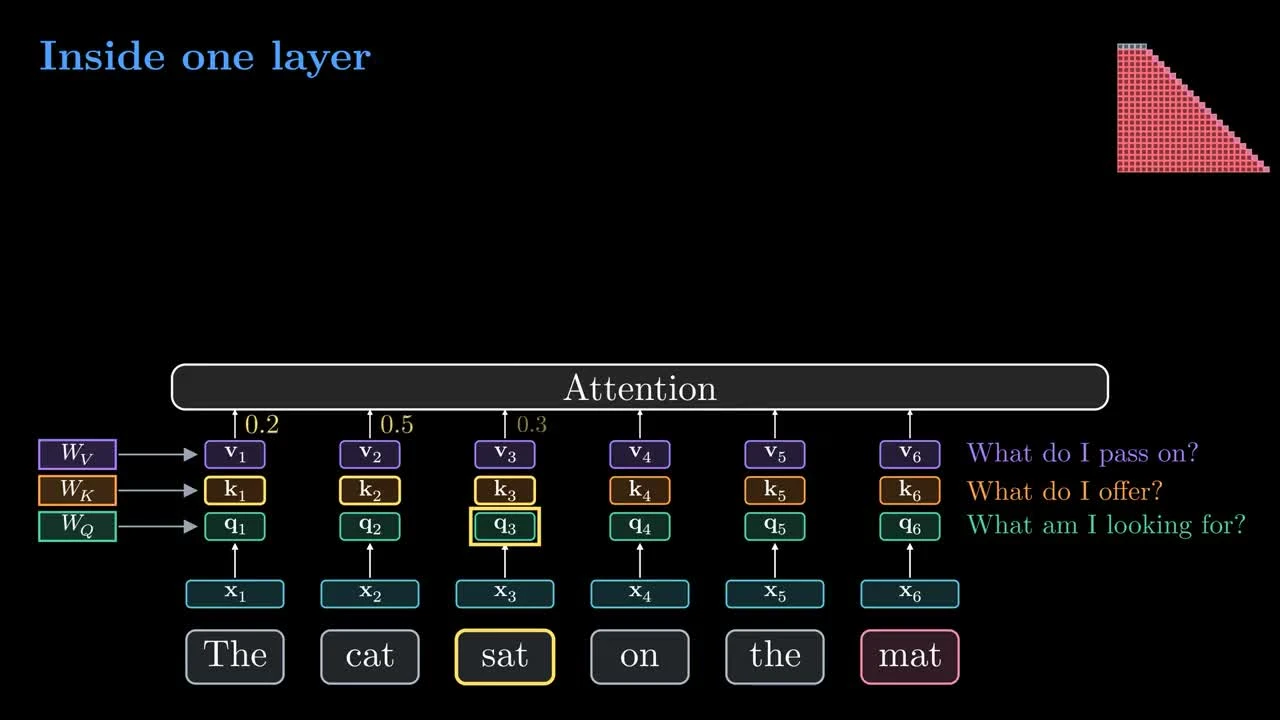
한 층에서 현재 위치가 앞선 토큰의 정보를 참조하는 어텐션 도식. Jia-Bin Huang, 3:50
캐시 크기는 토큰 수와 모델의 층, KV 헤드 수, 헤드 차원, 원소 정밀도에 따라 커진다. 예를 들어 Meta가 공개한 Llama 3.1 8B 구성은 32개 층, 8개 KV 헤드, 4,096차원과 32개 Query 헤드를 가진다. 헤드 차원은 4,096 ÷ 32 = 128이다. BF16을 사용해 K와 V를 각각 2바이트로 저장한다고 단순 계산하면 토큰 하나의 KV 크기는 다음과 같다.
따라서 131,072개 토큰의 캐시만으로 16GiB가 든다. 이 계산에는 모델 가중치와 임시 작업 공간, 캐시 블록의 남는 부분이 포함되지 않는다. 실제 서버에서 필요한 GPU 메모리는 더 크며, 캐시 정밀도와 동시 요청 수, 문맥 길이에 따라 달라진다. 8B라는 파라미터 수만 보고 서비스에서 동시에 처리할 수 있는 요청 수를 알 수 없는 이유다. Meta의 공개 모델 설정
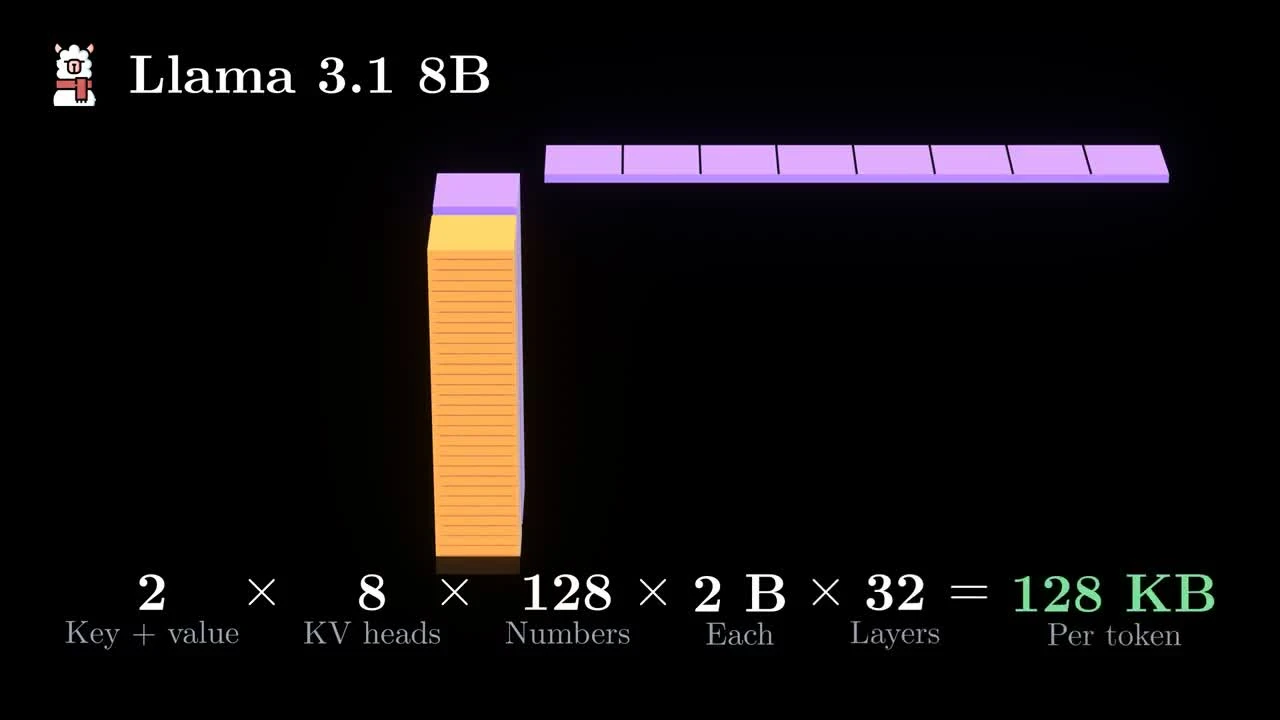
Llama 3.1 8B의 KV 크기 계산. 원본의 128 KB 표기는 계산상 128 KiB. Jia-Bin Huang, 5:50
입력을 읽는 단계와 답을 이어 쓰는 단계는 병목이 다르다
프롬프트를 처음 처리하는 단계는 prefill이다. 이때는 입력 토큰 여러 개를 함께 계산하므로 GPU의 행렬 연산을 넓게 활용할 수 있다. 한 번에 토큰 하나를 더하는 decode 단계에서는 각 활성 요청에 다음 토큰을 생성한다. 작은 배치에서는 연산량에 비해 모델 가중치와 KV 캐시를 메모리에서 읽는 비용이 커져 대역폭에 막히는 일이 많다. 긴 문맥일수록 새 토큰을 만들 때 읽어야 하는 과거 KV도 늘어난다.
영상은 이 차이를 가중치 16GB인 모델과 H100의 피크 성능으로 단순화해 보여 준다. 입력 1,000개를 함께 처리하면 같은 가중치를 읽어 약 16 TFLOP의 계산을 하지만, 토큰 하나를 처리할 때는 약 16 GFLOP만 계산한다. 그림의 메모리 대역폭 3.35 TB/s와 연산 성능 989 TFLOPS를 그대로 대입하면 가중치를 읽는 데 약 4.8ms, 연산에는 각각 약 16ms와 0.016ms가 필요하다. 이는 가중치 읽기와 연산량을 비교한 이론 예시이며, 작은 decode 배치에서 메모리 읽기가 시간을 지배하는 이유를 보여 준다.
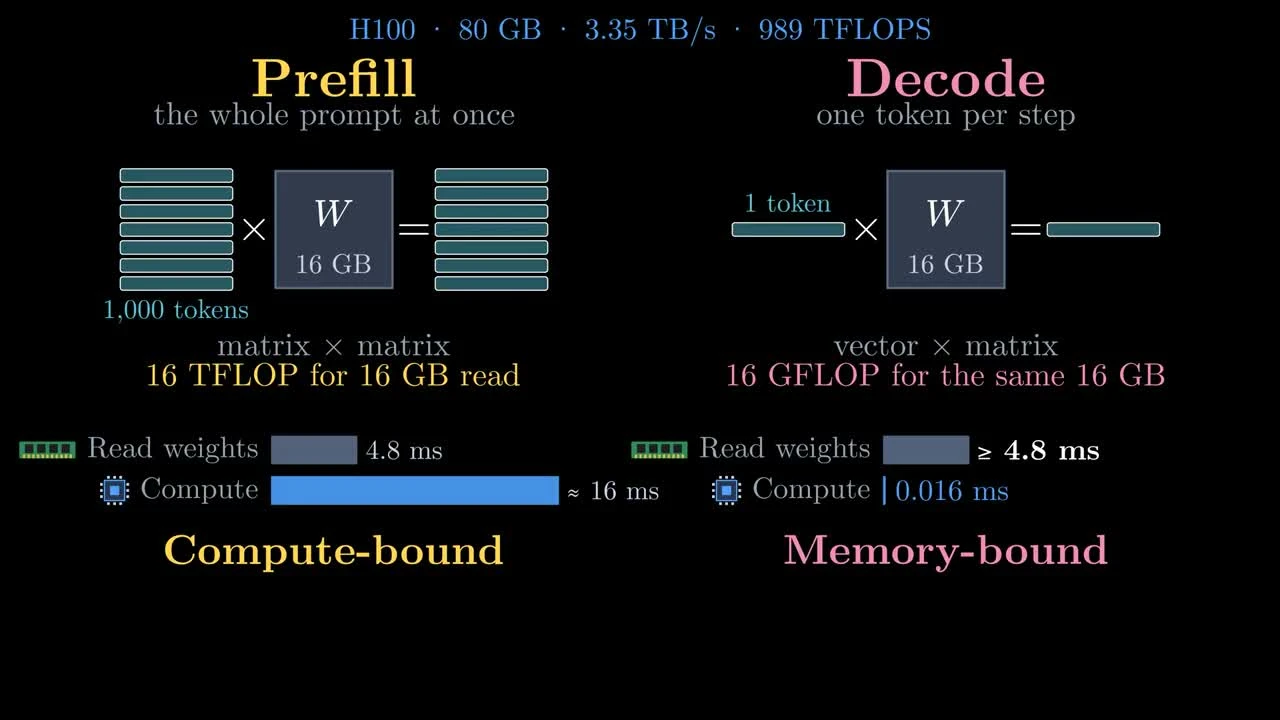
H100 피크 성능과 가중치 16GB, 입력 1,000개와 출력 한 토큰을 가정한 이론 비교. Jia-Bin Huang, 6:58
실제 병목은 배치 크기, 문맥과 출력 길이, 하드웨어, 모델 구현에 따라 움직인다. 여러 요청을 묶으면 가중치 한 번 읽기로 더 많은 토큰을 계산할 수 있다. 프로파일러에서는 GPU 연산량, 메모리 전송과 커널 사이의 빈 시간을 나누어 보고 어느 비용을 줄일지 정한다.
첫 토큰까지의 시간인 TTFT는 prefill 시간만을 뜻하지 않는다. 지표를 어디서 재기 시작하고 멈췄는지에 따라 요청 대기, 네트워크 이동과 스케줄러의 지연도 포함될 수 있다. TPOT는 출력 중 토큰 하나를 만드는 데 걸리는 시간을 나타내고, ITL은 인접한 출력 토큰 사이의 간격을 나타낸다. 같은 이름으로 보고된 숫자라도 스트리밍 방식과 측정 구간을 먼저 확인해야 사용자 경험과 비교할 수 있다.
배치는 처리량을 높이고, 스케줄러는 대기 시간을 조절한다
GPU가 여러 요청을 한 배치로 처리하면 가중치를 함께 사용해 총 처리량을 높일 수 있다. 정적 배치는 시작할 때 모인 요청을 끝까지 묶어 둔다. 출력이 짧은 요청이 먼저 끝나면 그 자리가 비어 있어도 다른 요청이 끝날 때까지 활용하기 어렵다.
Continuous batching은 토큰을 생성하는 단계마다 배치를 다시 구성한다. 응답을 마친 요청을 빼고 대기 중인 요청을 넣어 GPU의 빈 자리를 줄인다. 하지만 어떤 요청을 먼저 넣을지 정하면 응답 시간의 분포가 바뀐다. 오래 기다린 요청을 먼저 처리하면 공정성에 도움이 되고, 끝에 가까운 요청을 더 밀어 주면 일부 요청의 완료 시간을 줄일 수 있다.
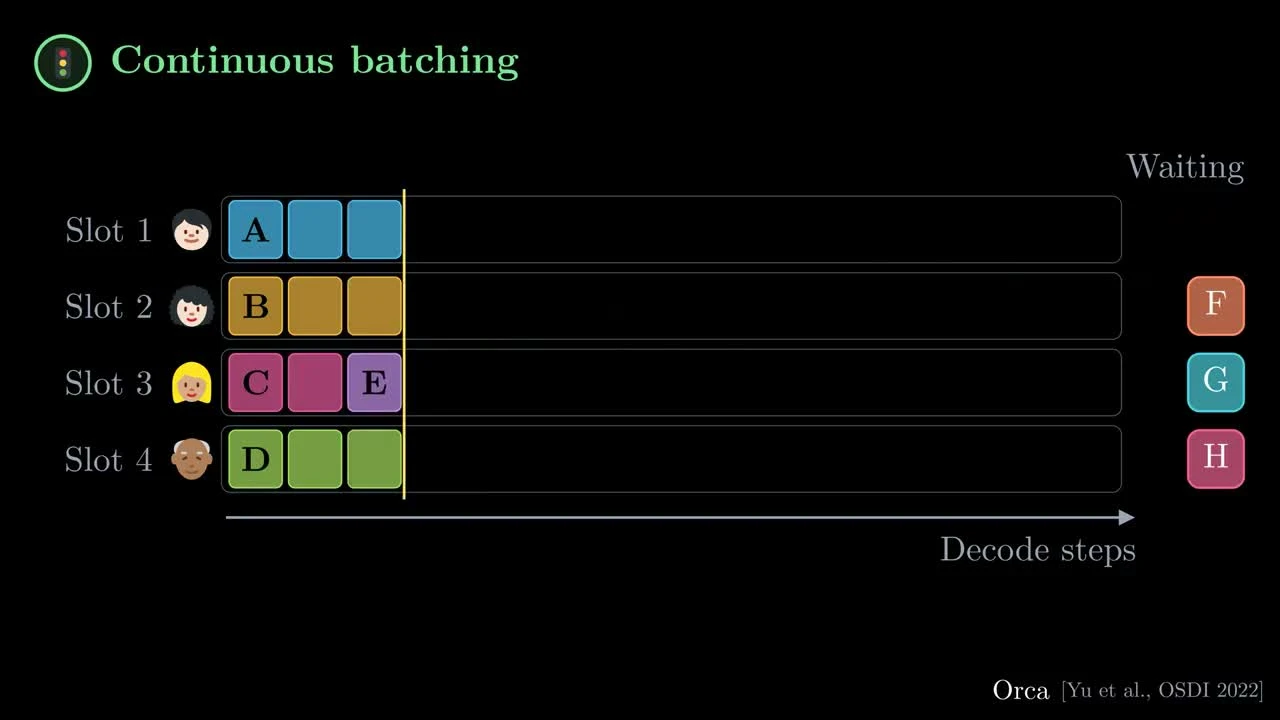
C가 끝난 자리에 E가 들어온 첫 교체 단계. Orca, OSDI 2022. Jia-Bin Huang, 9:15
긴 프롬프트의 prefill을 한 번에 실행하면 이미 토큰을 생성하던 요청들이 다음 토큰을 기다릴 수 있다. Chunked prefill은 입력을 조각내 decode 작업과 번갈아 처리한다. 입력 전체를 읽는 시간과 이미 생성 중인 요청의 토큰 간격 사이에서 균형을 잡는다. 청크 크기와 스케줄링 기준은 실제 입력 길이와 지연 목표를 보며 정해야 한다.
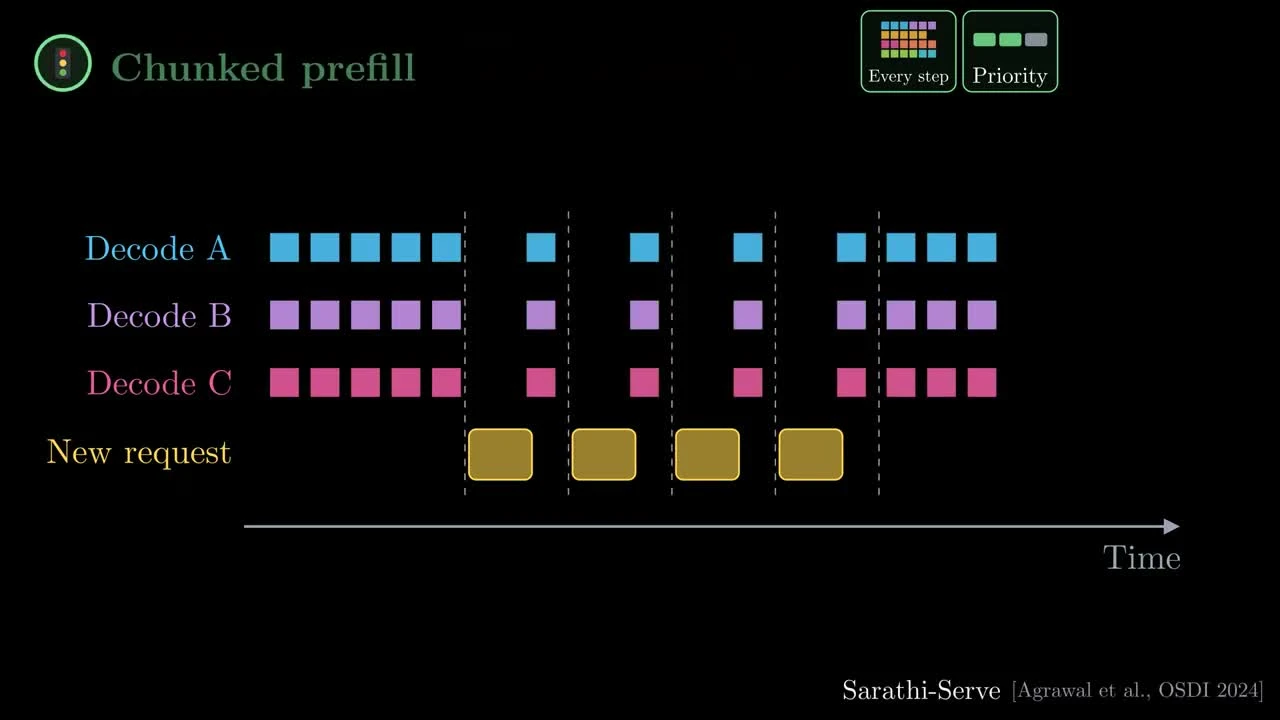
기존 요청의 decode 사이에 새 입력의 청크를 배치한다. 그림의 원자료는 Sarathi-Serve, OSDI 2024. Jia-Bin Huang, 10:20
일부 시스템은 prefill과 decode를 서로 다른 GPU 워커에서 처리한다. 이 분리 서빙은 입력 길이와 출력 길이가 다른 작업을 각각 맞춰 확장하기 쉽다. 대신 prefill 결과인 KV 상태를 다음 워커로 옮겨야 하므로 네트워크 대역폭과 전송 시간이 추가된다. 분리 전후를 비교할 때는 TTFT만이 아니라 생성 중 TPOT와 전송 비용, 전체 처리량도 함께 본다. DistServe 연구도 두 지연 목표를 충족한 요청의 처리량, 즉 goodput을 기준으로 비교한다. DistServe 논문
KV 캐시를 쪼개 두면 빈 공간과 재사용을 관리할 수 있다
요청마다 앞으로 생성될 최대 길이만큼 연속된 메모리를 미리 예약하면 실제 응답이 짧을 때 공간이 남는다. 반대로 필요한 만큼 계속 이어 붙이는 방식은 메모리가 조각나 빈 공간을 활용하기 어려워질 수 있다.
PagedAttention은 KV를 고정 크기의 블록으로 나누어 필요한 만큼 할당한다. 요청의 토큰 순서는 논리 블록 번호로 보관하고, 블록 테이블이 각 논리 번호를 GPU 메모리의 실제 위치에 연결한다. 그 결과 캐시가 연속된 큰 메모리 구역을 요구하지 않아도 된다. 요청이 늘면서 블록을 붙이고, 접두부가 같은 요청끼리 이미 계산한 블록을 공유할 수도 있다. 블록 안의 마지막 미사용 칸이나 시스템 작업 공간처럼 일부 낭비는 남는다. vLLM의 PagedAttention 논문
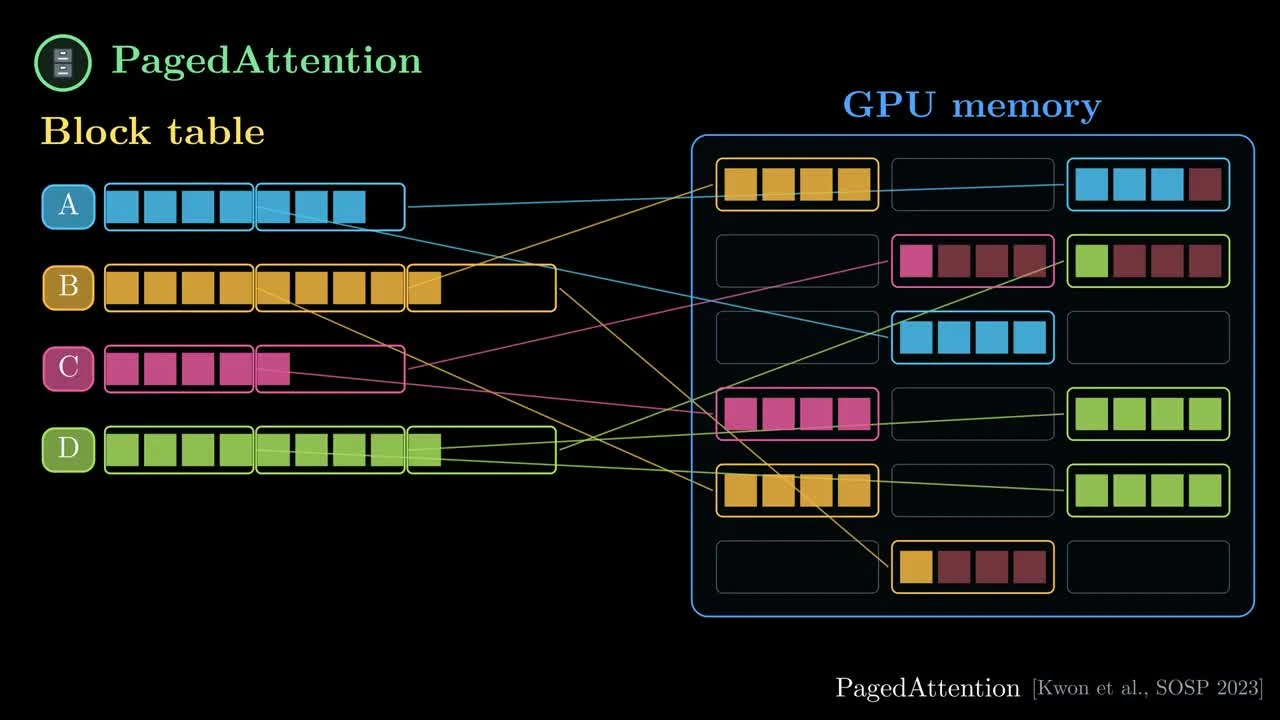
요청의 블록 순서는 블록 테이블이 유지하고 실제 저장 위치는 나누어 할당한다. Kwon 외, SOSP 2023. Jia-Bin Huang, 14:20
GPU 메모리가 부족해지면 서버는 요청을 일시 중단하거나 캐시를 다른 계층으로 내보낼 수 있다. 중단 후 다시 실행하는 정책에서는 캐시를 다시 계산하는 비용이 생기고, CPU 메모리나 외부 저장 장치로 옮기는 정책에서는 전송 비용이 든다. 선택은 캐시 크기와 장치 사이의 대역폭, 요청이 다시 도착할 때까지의 시간에 따라 달라진다.
반복되는 접두부를 찾으면 같은 계산을 아낄 수 있다
시스템 프롬프트, 자주 쓰는 지침, 같은 문서로 여러 번 대화하는 에이전트는 공통된 앞부분을 가진 요청을 만든다. 그 접두부의 KV가 남아 있으면 서버는 이를 다시 쓸 수 있다. 재사용은 앞에서부터 토큰열이 같은 구간에서 이뤄진다. vLLM은 앞선 블록의 해시와 현재 블록의 토큰을 이어 만든 키로 캐시를 찾고, 완전히 채워진 블록 단위로 재사용한다. 앞 블록의 해시를 포함하므로 중간 문구가 같아도 앞 문맥이 다른 경우를 구별할 수 있다. LoRA와 멀티모달 입력, 사용자 격리용 salt 같은 추가 조건도 키에 반영한다. vLLM의 prefix caching 설계
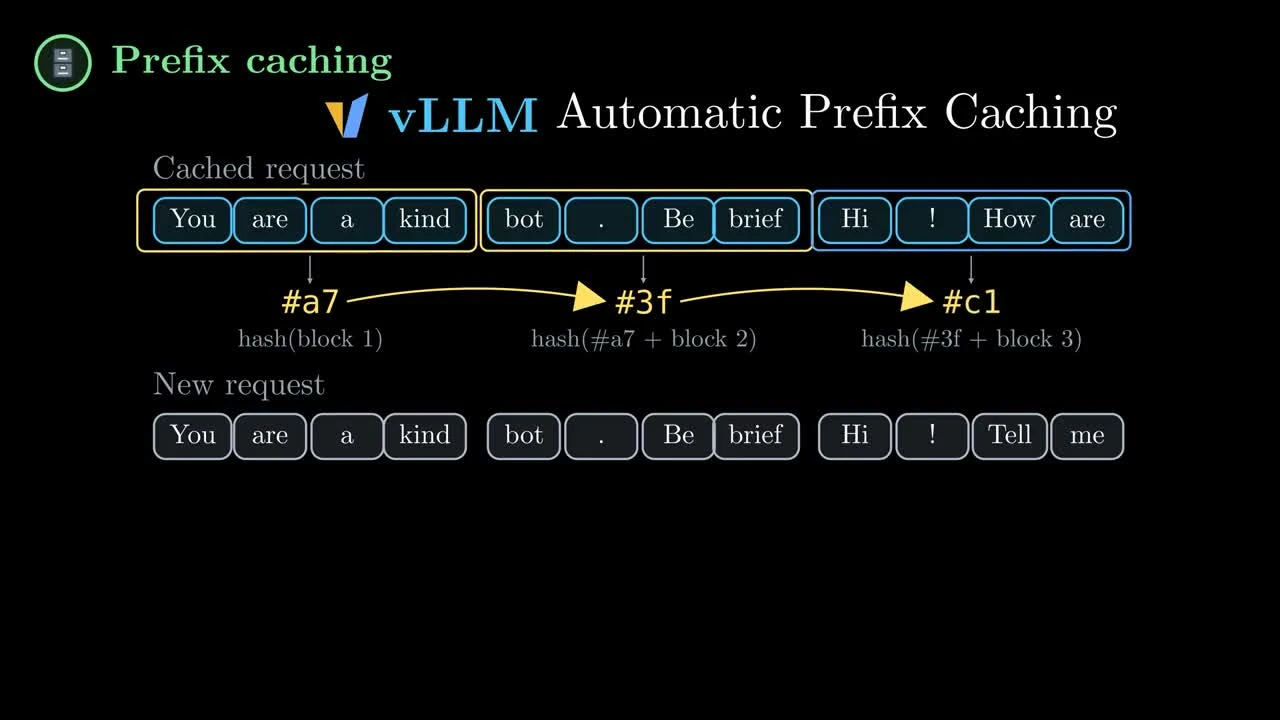
앞 문맥의 해시를 다음 블록에 이어 같은 접두부를 식별한다. Jia-Bin Huang, 17:20
SGLang은 공통 접두부를 radix tree에 저장한다. 가지가 나뉘기 전의 KV를 여러 요청이 공유하고, 새 요청에서 가장 긴 일치 접두부를 찾는다. 메모리를 비워야 하면 참조 중인 노드는 보호하고, 공유 자식이 없는 말단부터 최근 사용 시점을 기준으로 내보낸다. GPU 캐시를 CPU 메모리와 외부 저장 계층으로 늘리는 HiCache도 계층 사이의 복사 비용을 함께 따져야 한다. SGLang 논문 SGLang HiCache 안내
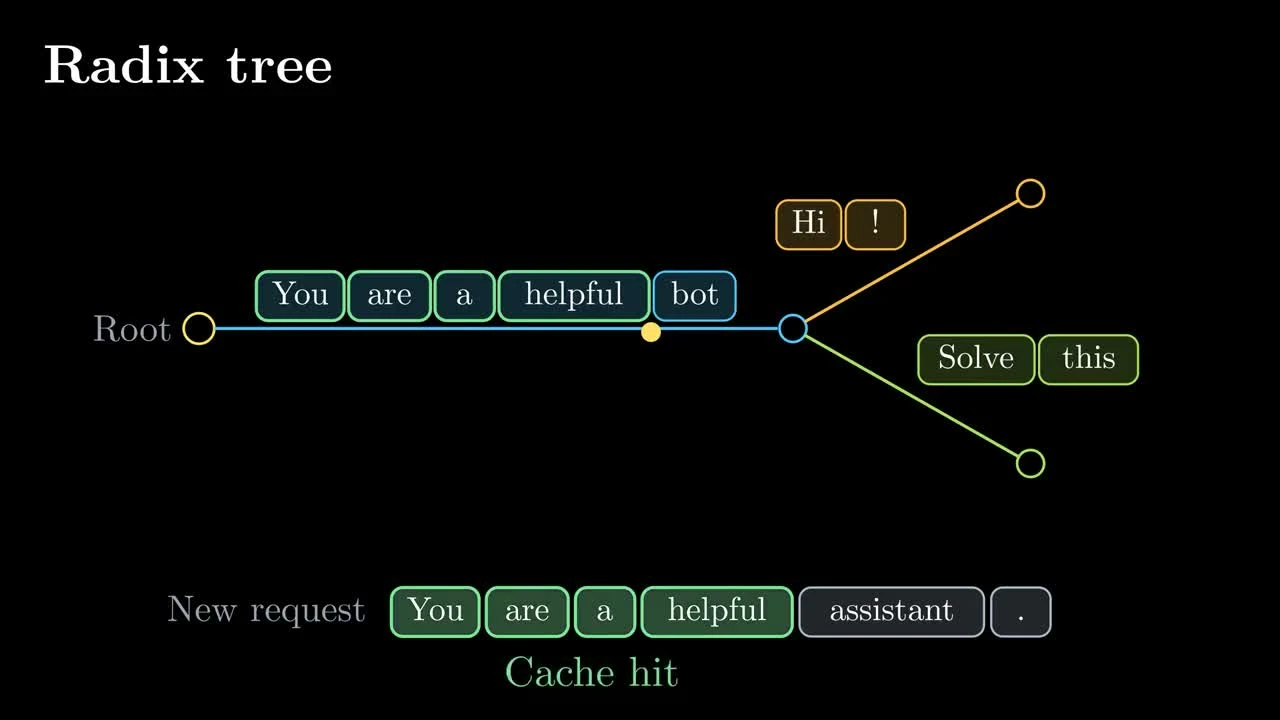
새 요청이 기존 경로와 어디까지 일치하는지 찾는 radix tree. Jia-Bin Huang, 18:40
입력이 A와 B의 접두부를 번갈아 포함하고 캐시에 둘 중 하나만 들어갈 수 있다면, 매번 다른 쪽으로 넘어갈 때 먼저 계산한 KV가 밀려난다. 이처럼 반복 요청이 캐시 용량과 맞지 않아 재계산을 일으키는 현상을 prefix thrashing이라고 한다. 같은 접두부를 공유하는 요청을 묶어 처리하면 중복 계산을 줄일 수 있지만, 뒤로 밀린 요청이 너무 오래 기다릴 수 있다.
영상은 캐시에 접두부 하나만 들어가고, 처음에는 C가 남아 있는 예를 든다. 대기열이 A, B, C, A, C, B, A, B, C이면 다음 요청이 올 때마다 캐시를 바꾸므로 접두부를 9번 계산한다. 순서를 C, C, C, A, A, A, B, B, B로 바꾸면 C는 기존 캐시를 쓰고 A와 B를 처음 만났을 때만 계산한다. 추가 접두부 계산은 2번으로 줄어든다. 요청의 내용과 캐시 크기는 같고 실행 순서만 달라진 것이다.
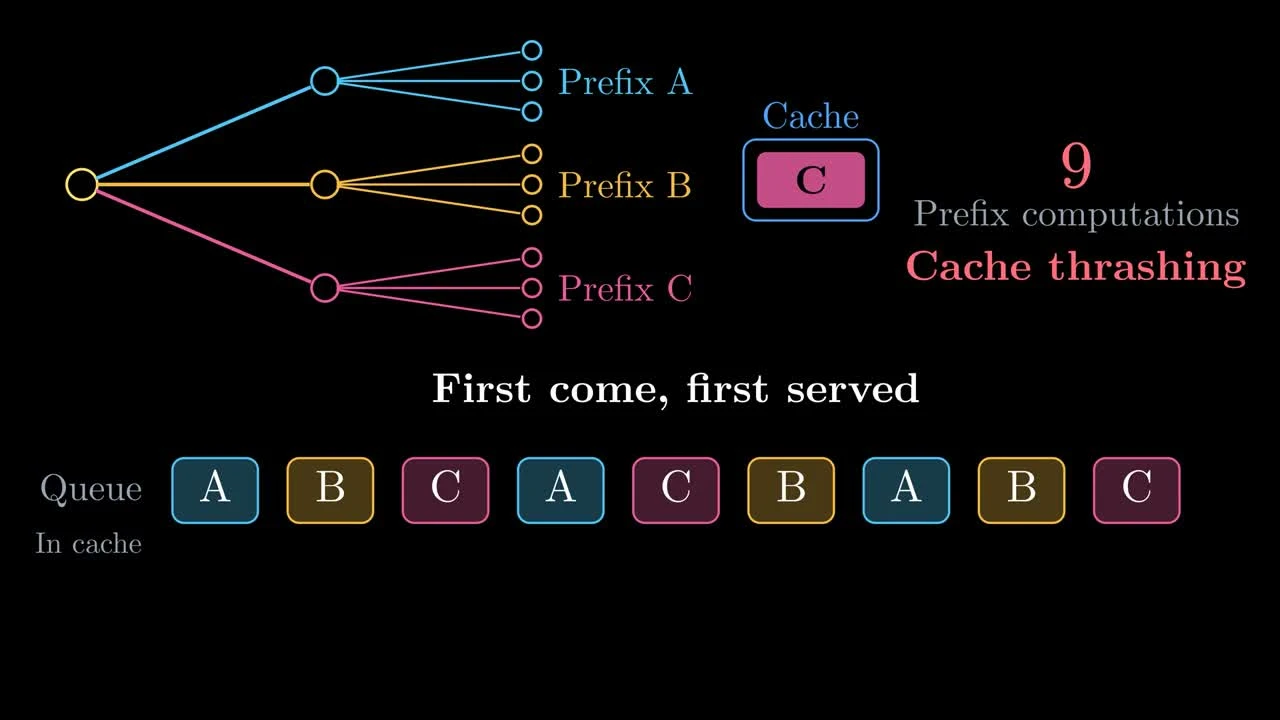
처음 C가 캐시에 있던 예에서, 요청이 섞인 순서는 접두부를 9번 계산한다. Jia-Bin Huang, 21:40
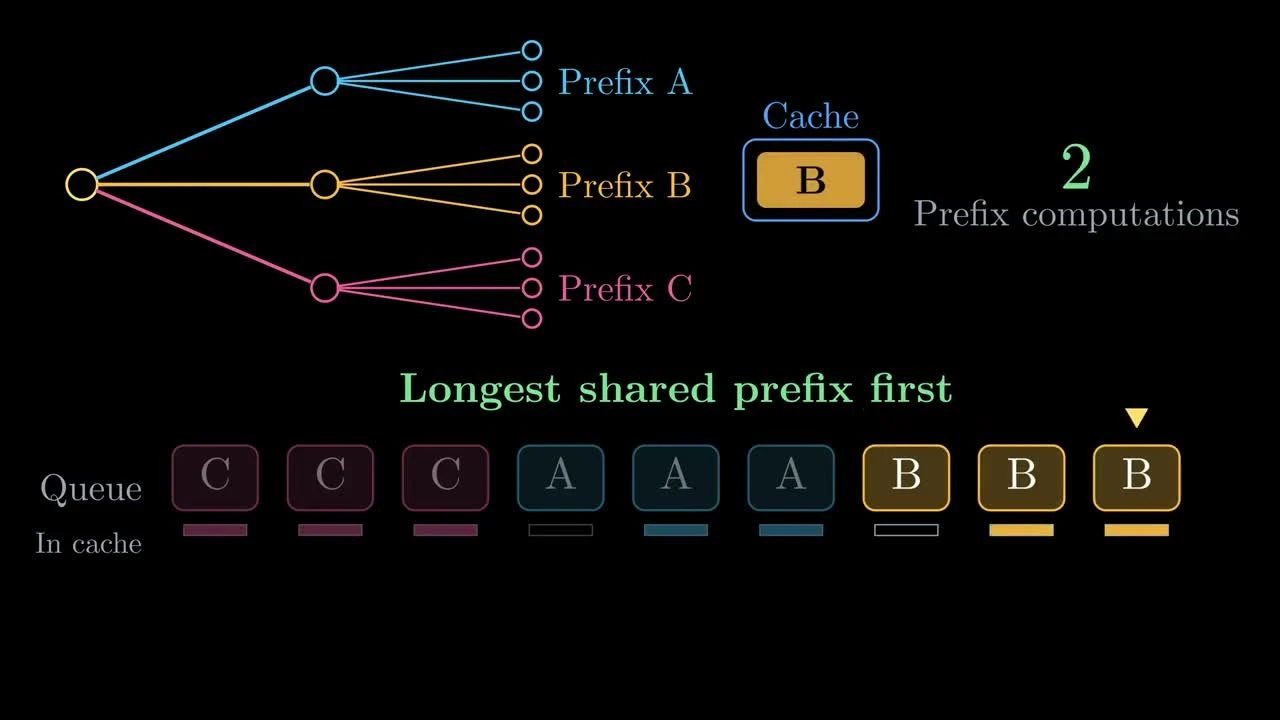
같은 초기 조건에서 C를 먼저 묶고 A와 B를 이어 처리하면 추가 계산은 2번. Jia-Bin Huang, 22:30
SGLang 논문은 미리 주어진 요청 배치와 가장 긴 요청을 담을 수 있는 캐시를 전제로, radix tree를 깊이 우선 순서로 방문하면 최적 캐시 적중률을 얻는다고 증명한다. 실시간 서비스에서는 새 요청이 도착하고 출력 길이도 달라지므로 이 재사용 이득과 오래 기다린 요청의 우선순위를 함께 조정해야 한다. 논문의 벤치마크 결과는 최적 적중률 대비 평균 96%에 도달했고, 여러 최적화를 합친 처리량 개선은 당시 비교에서 최대 6.4배였다. SGLang 원 논문
정해진 형식은 문법으로, 빠른 생성은 검증으로 돕는다
JSON처럼 출력 형식이 정해져 있다면 허용된 문법에 맞는 다음 토큰만 샘플링하도록 마스킹할 수 있다. 이 방식은 쉼표나 괄호를 잘못 놓는 형식 오류를 줄인다. XGrammar 같은 도구는 문법 상태와 토크나이저가 만드는 여러 토큰 경계를 함께 처리한다. 예를 들어 grade 값을 A, B, C, D 중 하나로 제한할 수 있다. 어떤 등급이 내용에 맞는지는 모델의 판단과 애플리케이션의 검증이 맡는다. XGrammar의 constrained decoding 안내
문법의 어떤 상태에서 다음 문자열이 하나로만 결정된다면 그 고정 구간을 묶어 처리할 수 있다. 예를 들어 스키마에서 첫 필드가 정해져 있으면 {"summary": "를 채우는 동안은 선택할 내용이 없다. SGLang의 compressed FSM은 이렇게 갈림길 없는 전이를 합쳐 다음 분기까지 jump-forward한다. 묶은 문자열을 한 번의 모델 실행에서 처리해 KV 상태를 이어 만들고, 실제 내용을 고를 지점에서 다시 샘플링한다. 문자열과 모델 토큰의 경계가 다를 수 있어 경계에서 토큰화를 맞추는 처리도 필요하다. SGLang의 compressed FSM 설명
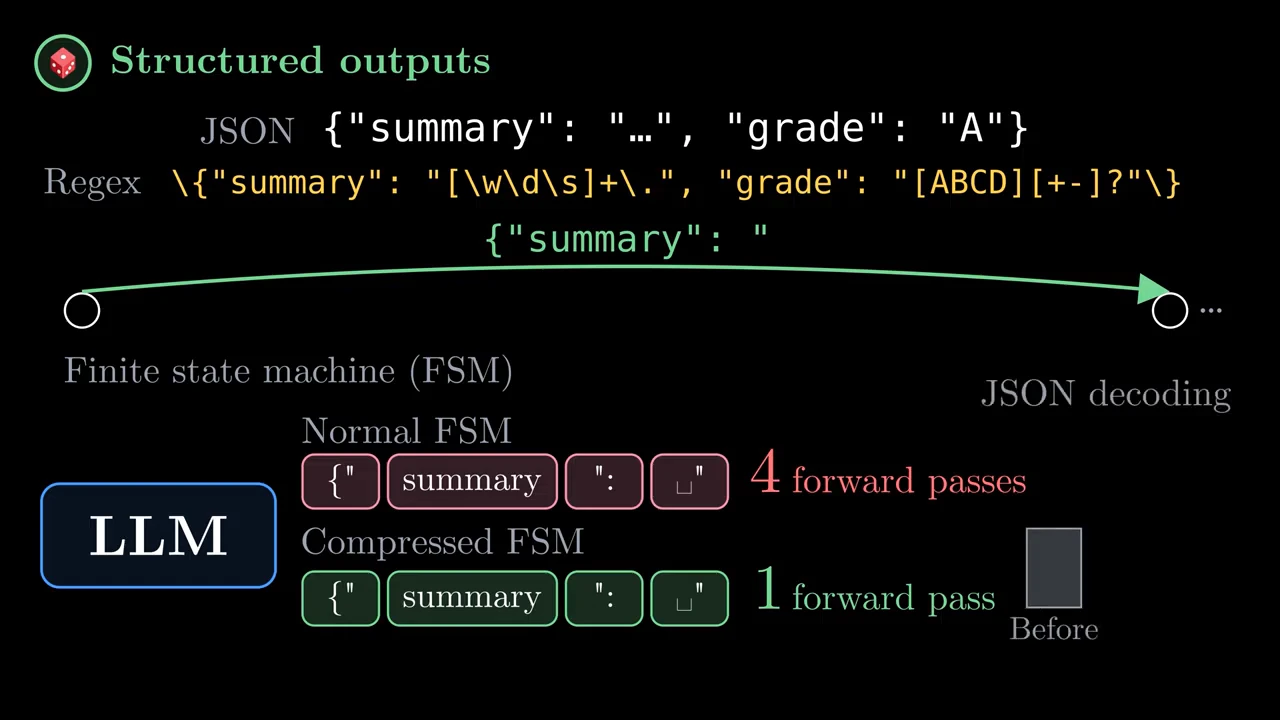
고정 문자열을 한 번에 처리하는 compressed FSM의 설명 예제. Jia-Bin Huang, 26:05
Speculative decoding은 후보 토큰을 빨리 만들어 큰 모델의 계산을 아끼려는 방법이다. 작은 draft 모델이나 n-gram proposer가 후보를 내고, target 모델은 그 후보들을 한 번에 검증한다. 검증에 통과한 연속 토큰을 받아들이고, 거절 지점에서는 target 분포에 맞춘 대체 토큰을 고른 뒤 proposer를 다시 실행한다. 확률적 생성에서 적절한 rejection sampling으로 채택과 거절 시의 분포를 보정하면 원래 target 모델의 출력 분포를 유지할 수 있다. Medusa처럼 여러 출력 head를 두거나, EAGLE처럼 중간 표현으로 후보를 만들거나, n-gram으로 이미 입력에 있는 조각을 후보 삼는 방법은 후보를 만드는 방식이 다르다. 높은 채택률은 유리하지만 proposer 계산도 공짜는 아니다. 배치가 커져 target GPU가 충분히 바쁠 때는 후보 계산과 검증으로 절약하는 시간이 줄 수 있어 accepted token 수, 검증 비용과 함께 재야 한다. vLLM의 speculative decoding 문서
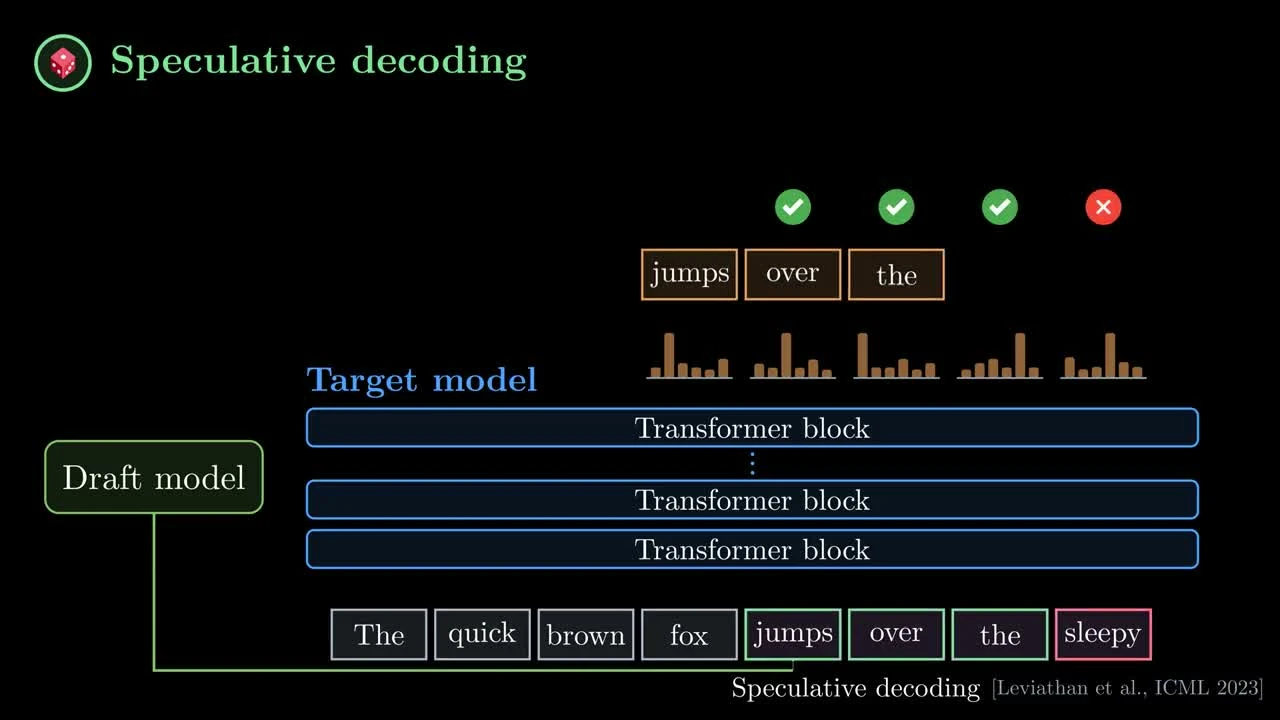
제안한 후보를 target 모델이 검증해 앞의 세 토큰을 연속 채택한다. Leviathan 외, ICML 2023. Jia-Bin Huang, 27:20
GPU 메모리 왕복과 CPU 호출을 줄이는 커널 기법
어텐션의 중간 점수 행렬을 통째로 GPU 메모리에 쓰고 다시 읽으면 긴 문맥에서 메모리 이동이 커진다. FlashAttention은 Query, Key, Value를 타일 단위로 가져와 GPU 안쪽의 빠른 메모리에서 계산하고, online softmax로 정규화에 필요한 값을 누적한다. 결과를 만드는 수학적 연산을 바꾸지 않으면서 중간 행렬의 메모리 왕복을 줄이는 접근이다. 실제 KV를 페이지로 나누어 저장하는 서빙에서는 이 블록을 읽는 구조에 맞춘 커널이 필요하다. FlashAttention 논문
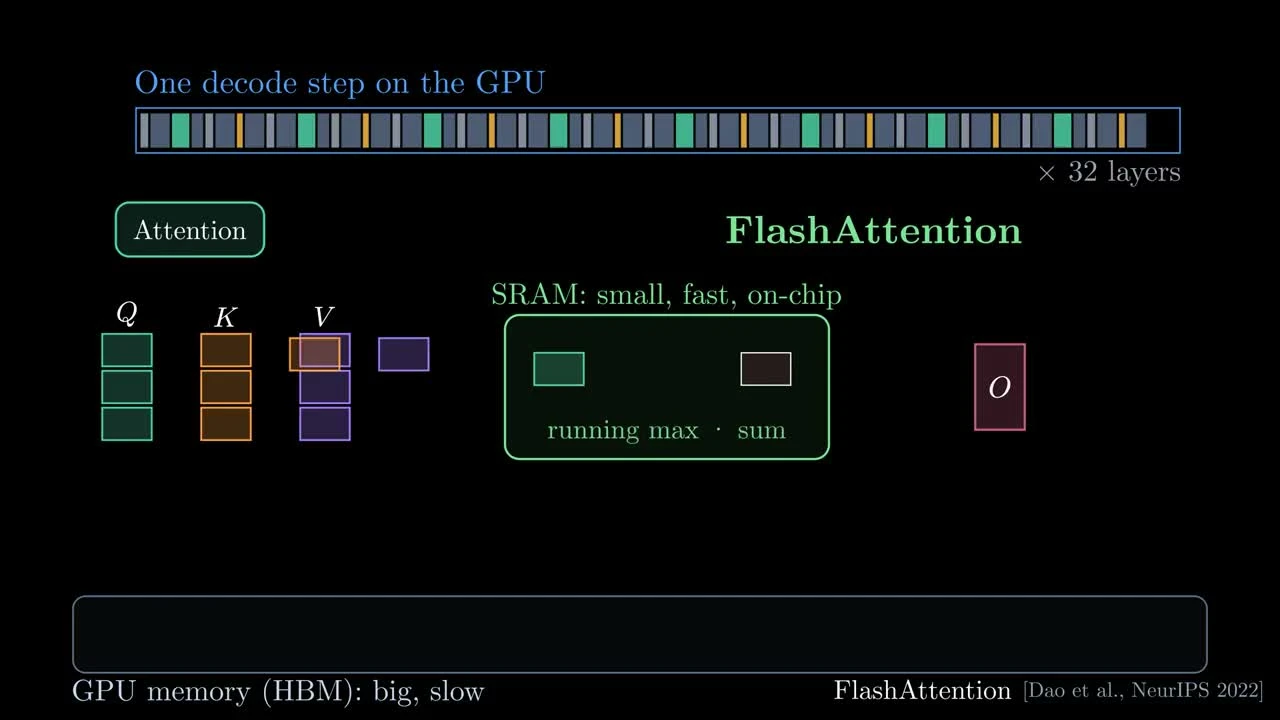
작은 on-chip 메모리에서 타일별 계산과 online softmax를 이어 가는 과정. Dao 외, NeurIPS 2022. Jia-Bin Huang, 30:18
GPU 커널이 짧게 끝나는 모델에서는 CPU가 다음 커널을 실행하라고 부르는 비용이 전체 시간에서 눈에 띌 수 있다. CUDA Graph는 반복할 실행을 미리 캡처한 뒤 그래프 호출 하나로 재생해 CPU launch 비용을 줄인다. 그 대신 캡처 과정에서 사용하는 메모리 주소와 텐서 형태가 고정되어야 한다. 배치가 달라지는 요청은 미리 정한 크기에 맞춰 padding하거나 별도의 실행 경로를 두어야 하며, 빈칸에 넣은 계산이 이득을 줄일 수도 있다. 영상에서 5개 요청을 크기 8 그래프에 padding한 그림은 이 선택을 보여 준다.
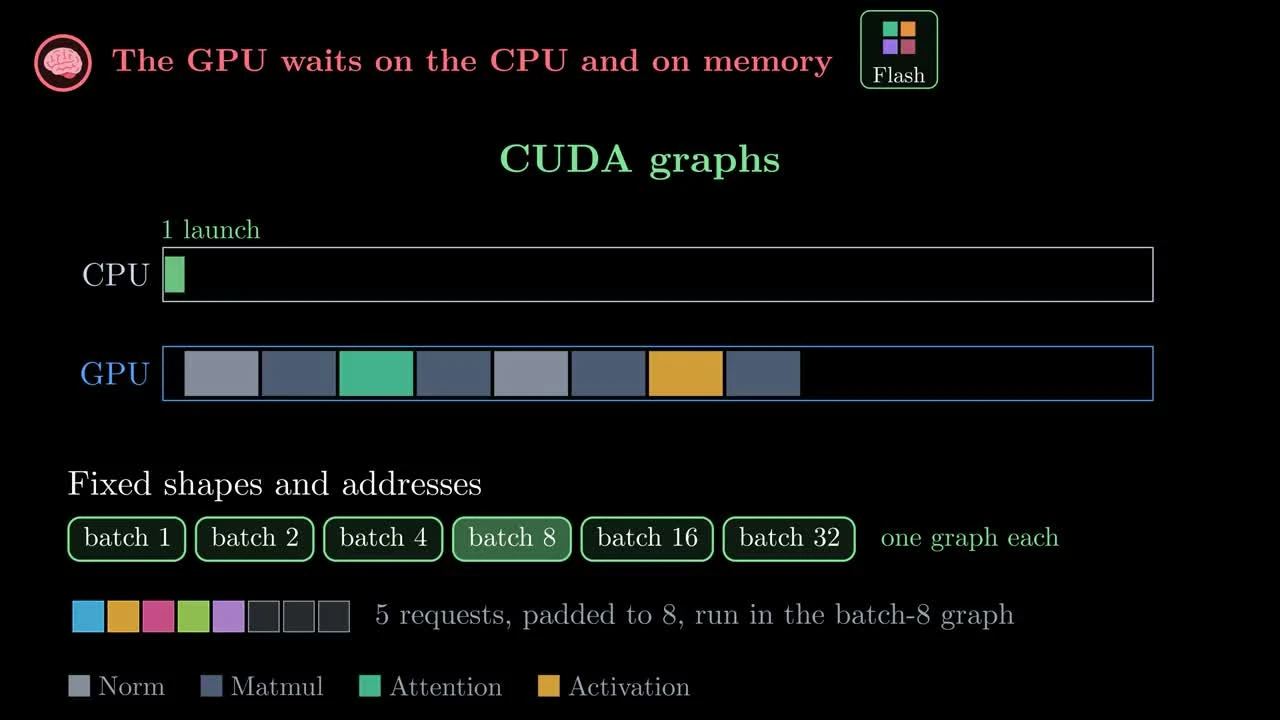
크기가 고정된 그래프를 재생하기 위해 요청 5개를 batch 8에 맞춘 예. Jia-Bin Huang, 32:10
GPU 내부에서 이어서 실행하는 작은 연산을 한 커널로 합치는 fusion은 중간 메모리 저장과 커널 호출을 줄이는 별도 기법이다. CPU가 다음 계산을 준비하는 동안 GPU가 이미 준비된 일을 하게 겹치는 scheduling도 두 프로세서의 빈 시간을 줄인다. 가중치와 KV를 낮은 비트 수로 저장하는 양자화는 메모리 사용량과 이동량을 줄일 수 있다. 모델의 수치 품질과 사용할 커널이 실제로 그 정밀도를 빠르게 처리하는지 함께 측정해야 한다. 프로파일링에서 드러난 병목에 맞춰 이 기법들을 조합하고, 같은 모델과 부하에서 지연과 처리량이 얼마나 달라지는지 판정한다.
여러 GPU에서는 모델의 분할과 통신도 비용이다
모델 가중치가 GPU 한 장의 메모리에 들어가지 않거나 처리량을 늘려야 하면 tensor parallelism으로 가중치를 여러 GPU에 나눈다. 각 GPU가 일부 행렬 연산을 맡은 뒤 중간 결과를 모으므로 계산을 나눈 만큼 장치 간 통신이 더해진다. 모델 구조와 배치가 작으면 이 통신 비중이 커질 수 있다.
DeepSeek V3의 Multi-head Latent Attention(MLA)은 어텐션 캐시를 압축해 KV 메모리를 절약한다. 여러 Query 헤드가 압축된 KV 표현을 함께 쓰는 구조라서, 헤드를 여러 GPU에 나누면 각 GPU가 같은 압축 캐시를 보관하는 실행 경로가 생길 수 있다. Attention을 data parallel로 나누어 GPU마다 다른 요청을 맡기면 이런 중복을 줄일 수 있다. vLLM의 공개 설계는 일부 MLA MoE 구성에서 attention에 data parallelism을 적용하고 expert 계산에는 expert parallelism 또는 tensor parallelism을 조합한다. 이때 attention 요청은 data-parallel rank들로 나뉘고 expert 계산은 해당 group에서 함께 수행된다. 즉 attention은 서로 다른 요청을 맡고, expert 층에서는 같은 병렬 그룹의 GPU들이 통신하며 계산한다. vLLM의 MLA와 MoE 분산 구성
Mixture of Experts(MoE)는 토큰마다 일부 전문가만 계산한다. 각 토큰이 계산하는 전문가는 일부여도, 배치 전체에서는 서로 다른 많은 전문가가 선택될 수 있다. Expert parallelism은 전문가 가중치를 GPU들에 나눈다. 더 많은 GPU에 전문가를 넓게 배치하는 wide expert parallelism은 한 GPU가 읽어야 하는 가중치를 줄이는 방향이다. 토큰을 담당 GPU로 보내고 결과를 모으는 dispatch와 gather가 따라오며, 한 전문가에 토큰이 쏠리거나 한 GPU가 늦으면 전체 단계가 그쪽을 기다린다. 전문가별 부하를 고르게 두는 일이 산술량을 줄이는 것만큼 중요하다.
영상의 DeepSeek V4.1 Flash 도식은 이 차이를 구체화한다. 공개 설정의 routed expert는 384개이고 토큰마다 그중 6개를 선택하며 shared expert 1개도 둔다. 토큰 하나가 쓰는 전문가 수와, 여러 요청이 모였을 때 배치 전체에서 읽어야 하는 전문가 가중치의 범위가 다른 것이다. DeepSeek V4.1 Flash 모델 설정
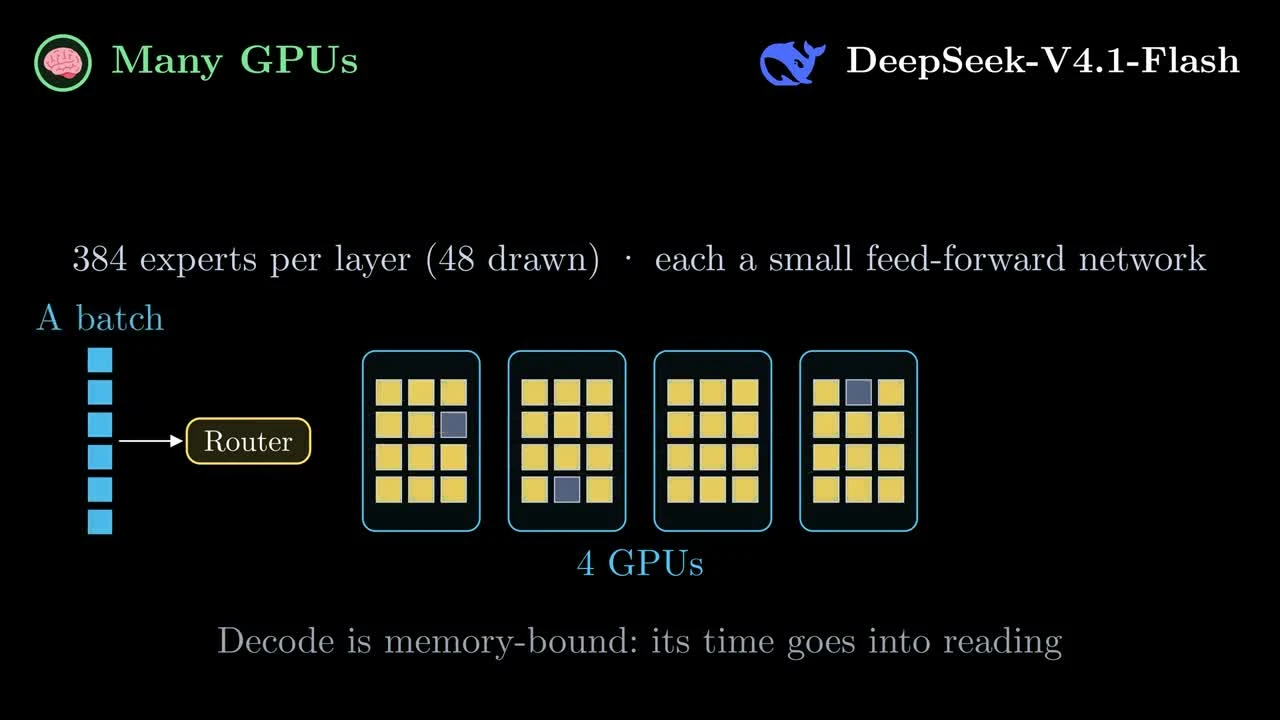
배치의 토큰을 GPU별 전문가로 나누는 예. 모델의 routed expert 수는 384개. Jia-Bin Huang, 37:30
여러 GPU 묶음이 독립적으로 같은 모델을 실행할 때도 각 묶음의 prefix cache는 서로 다를 수 있다. Cache-aware router는 요청에 맞는 KV가 있는 복제본을 선호하되 그 GPU가 이미 바쁜지도 살핀다. 캐시를 살리느라 한 복제본에 계속 요청을 보내면 대기열이 쌓인다. 요청의 재사용 이득과 워커의 현재 부하를 함께 비교해야 한다.
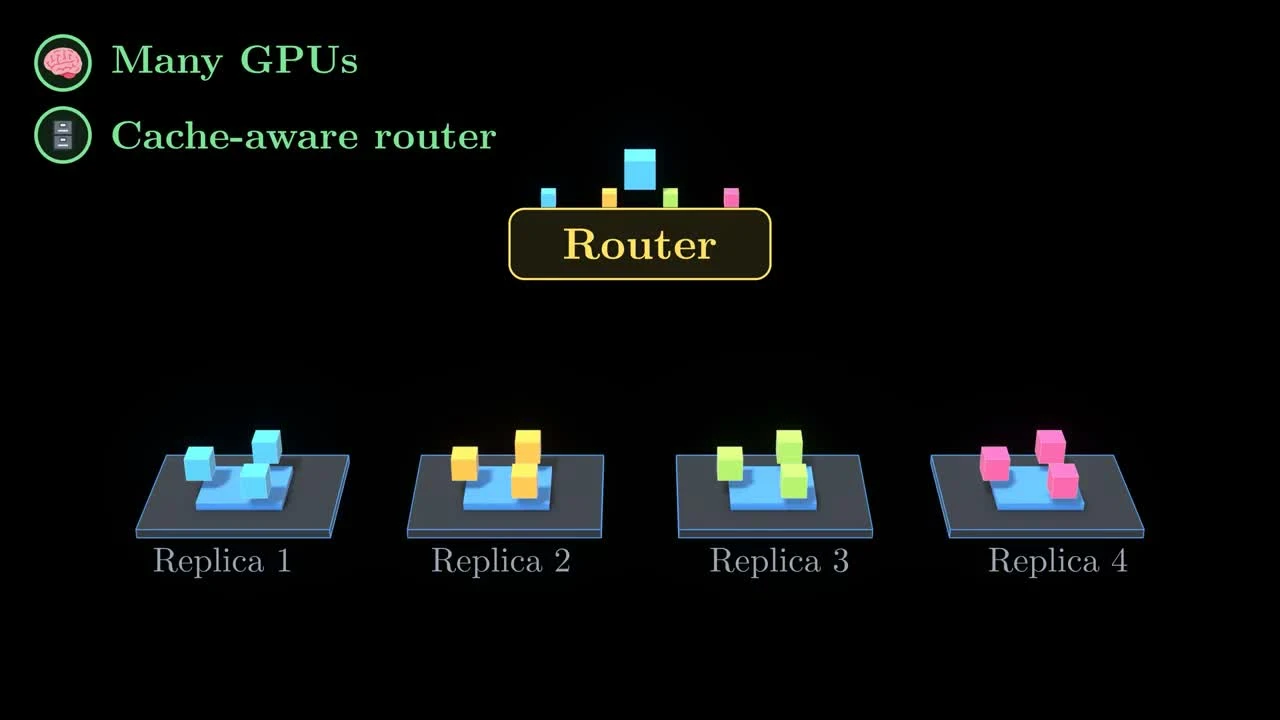
서로 다른 캐시를 가진 복제본에 요청을 배정하는 라우터. Jia-Bin Huang, 39:30
2026년 11월 2일 확인한 DeepInfer 공개 저장소는 모델과 샘플러 실행, 최적화 커널, 병렬 처리와 비동기 스케줄링을 제공한다. 완전한 서비스를 위해 필요한 KV 캐시 시스템, VE/prefill/decode 분리, data-parallel 복제본 사이의 부하 분산은 별도로 구현해야 하는 영역으로 명시한다. 모델 실행 엔진을 상위의 요청 관리와 캐시 운영에 연결해야 서비스 구성이 완성된다.
빠른 한 요청과 전체 시스템의 처리량은 따로 잰다
서빙 성능을 비교할 때 최소 네 항목은 함께 봐야 한다.
| 기준 | 답하는 질문 |
|---|---|
| TTFT | 요청 후 첫 토큰을 받을 때까지 얼마나 기다렸나 |
| TPOT 또는 ITL | 출력 토큰이 이어지는 속도는 어떤가 |
| 처리량 | 시스템이 초당 요청이나 토큰을 얼마나 처리했나 |
| Goodput | 지연 목표를 만족한 요청을 단위 시간에 얼마나 완료했나 |
TTFT가 줄어도 생성 속도가 느려질 수 있고, 한 요청이 빨라져도 GPU 전체의 처리량이 낮아질 수 있다. 처리량을 높이느라 대기열이 길어지면 지연 목표를 만족하는 요청 수는 오히려 줄어든다. 같은 입력과 출력 길이, 요청률, 동시성, 하드웨어, 모델과 정밀도에서 네 지표를 비교해야 개선의 의미가 분명해진다.
좋은 서빙 설계는 사용자가 기다릴 수 있는 시간 안에서 더 많은 요청을 완료한다. 어떤 요청을 함께 계산할지, 이미 가진 KV를 언제 재사용할지, 메모리와 커널 작업을 어떻게 나눌지, 밀려든 요청을 어떻게 받을지 결정하고 그 결과를 첫 응답과 이어지는 속도로 확인한다. 모델 계산, 메모리, 대기와 통신을 한 흐름에서 다뤄야 서비스에서 쓸 수 있는 처리량이 나온다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/records/llm-serving-requests-memory-kv-cache/index.md'