 Readiz
AI 서빙의 지연과 용량을 읽는 법
TTFT와 TPOT, Goodput, KV 크기, PagedAttention, 접두부 재사용, CUDA Graph와 분리 서빙의 구조와 성능 해석 기준.
글 관리 · 공개 범위AI 서빙의 성능을 읽을 때는 첫 응답 지연, 생성 중 속도, 전체 처리량을 나누어 봐야 한다. GPU 연산량이 같아도 CPU의 호출 비용과 대기열, KV 캐시의 위치, 워커 배치에 따라 사용자가 기다리는 시간은 달라진다. 이 문서는 그 차이를 확인할 공식 자료와 지표의 해석 기준을 모은다.
지연과 처리량의 단위
| 지표 | 읽는 방법 | 함께 남길 조건 |
|---|---|---|
| TTFT | 요청 후 첫 토큰까지의 시간 | 네트워크와 큐 대기 포함 여부, 입력 길이, p50 또는 p99 |
| TPOT 또는 ITL | 출력 토큰당 시간 또는 토큰 사이 간격 | 계산 정의, 출력 길이, 스트리밍 방식 |
| TTFA | 요청 후 첫 오디오까지의 시간 | 첫 오디오 조각의 기준과 길이, 전처리 포함 여부 |
| RTF | 오디오 생성 시간 ÷ 생성된 음성의 재생 길이 | 모델, 음성 길이, 스트리밍과 동시 부하 조건 |
| 처리량 | 단위 시간에 완료하거나 생성한 요청 또는 토큰 수 | 요청/초, 요청/분, 토큰/초 등 단위와 입력/출력 구분 |
| 동시성 | 한 시점에 진행 중인 요청 수 | 클라이언트 동시성인지 엔진 활성 시퀀스인지 |
RTF는 작을수록 빠르고 1 미만이면 재생 길이보다 짧은 시간에 생성한다. 반대로 NVIDIA AIPerf의 음성 전사 지표 RTFx는 음성 길이 ÷ 요청 지연으로 정의되므로 클수록 빠르다. 이름이 비슷해도 분자와 분모를 먼저 확인한다. AIPerf 지표 정의
TTFT에는 큐 대기와 입력 처리 등이 포함될 수 있다. p50은 중앙값이고, p99는 느린 꼬리 구간의 지연을 보여 준다. 사용자당 생성 속도가 개선된 배율과 시스템 전체 처리량의 개선 배율은 같은 값일 필요가 없다.
CPU 호출 병목과 CUDA Graph
GPU에서 실행하는 커널이 짧으면 CPU가 다음 커널을 준비하고 호출하는 비용의 비중이 커질 수 있다. CUDA Graph는 반복 작업을 기록하고 그래프 단위로 재실행해 호출 오버헤드를 줄인다. GPU 계산 자체가 가장 오래 걸리는지, 커널 사이가 비어 있는지를 프로파일링으로 구분할 때 유용한 개념이다.
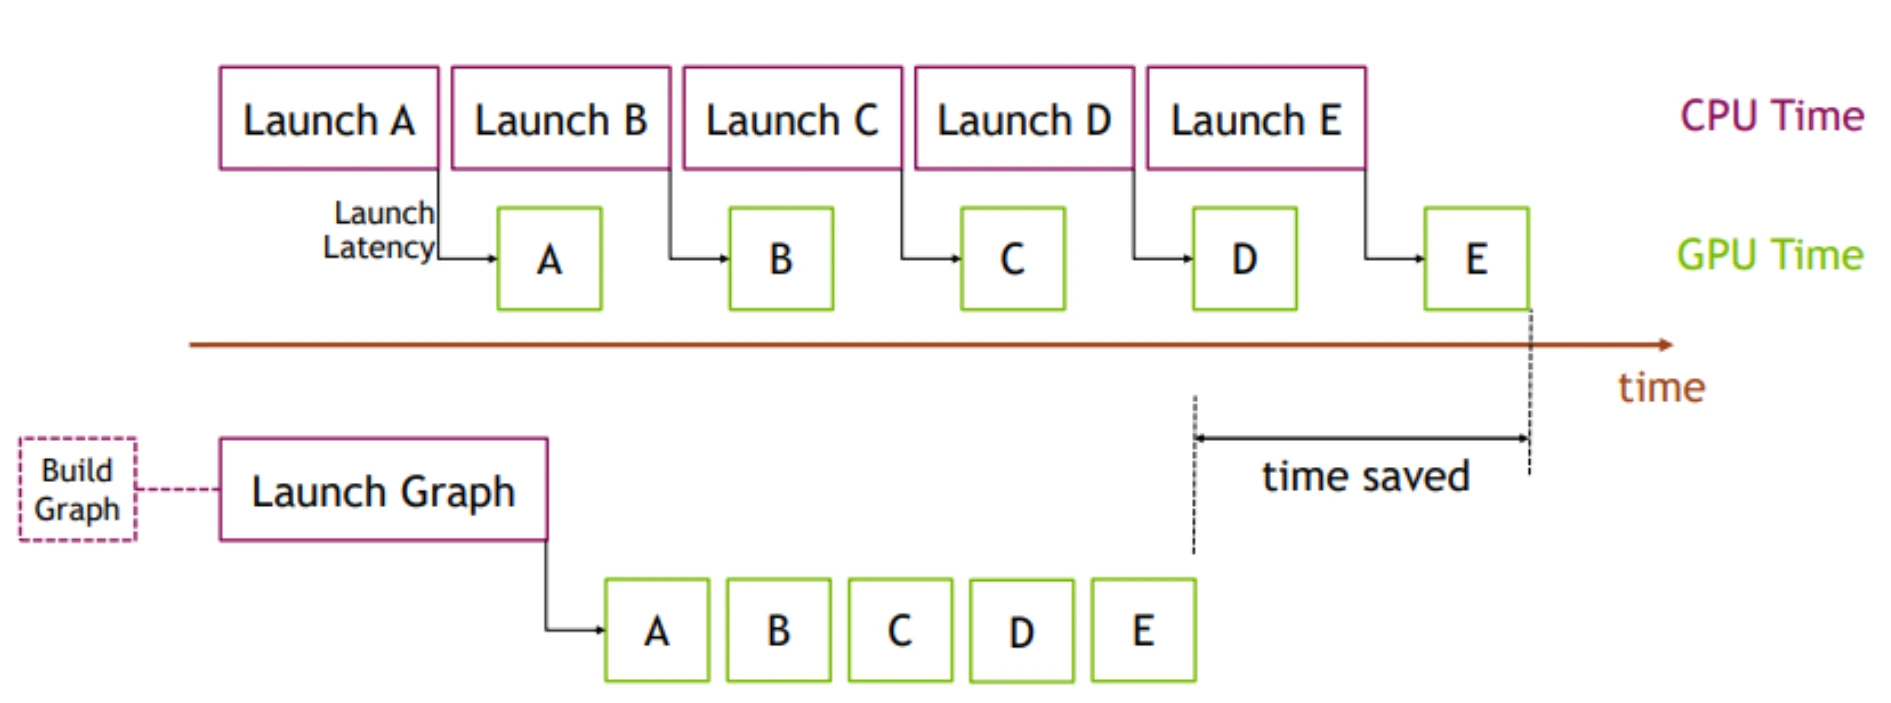
각 GPU 작업을 따로 호출하는 방식과 그래프 단위 재실행. 시간 비율은 측정값이 아닌 설명용 도식. PyTorch 공식 글, 2021-10-26
PyTorch 2.14 CUDA semantics는 재실행 시 같은 메모리 주소를 사용하고 텐서 형태가 고정돼야 한다고 설명한다. CPU 코드는 캡처 후 재실행되는 대상이 아니다. 입력을 정해진 버퍼에 복사하고, 동적 부분은 별도 실행 경로로 처리하는 등 엔진 설계가 필요하다. CUDA Graph와 커널 fusion도 구분한다. 전자는 작업 호출을 묶고, 후자는 여러 연산을 하나의 커널로 합쳐 중간 메모리 접근과 실행 비용을 줄인다.
KV 크기와 블록 할당
KV 캐시를 요청마다 최대 문맥 길이만큼 연속된 메모리에 예약하면 실제 출력 길이가 짧은 요청의 공간이 남는다. 연속 메모리에서 토큰이 늘어날 때마다 구역을 확장하면 할당이 단편화될 수도 있다. vLLM의 PagedAttention은 토큰별 KV를 고정 크기의 블록에 할당하고 블록 테이블로 논리 순서와 GPU 메모리의 위치를 연결한다. 요청 길이만큼 블록을 붙이므로 같은 접두부가 있는 요청의 블록을 공유할 수 있고, 한 덩어리의 큰 메모리 구역을 요구하지 않는다. 마지막 블록의 남은 칸과 블록 테이블은 여전히 비용이다. 메모리가 모자랄 때 요청을 선점해 중단하거나 KV를 이동하는 방식은 버전과 엔진 정책에 따라 다르다. vLLM 논문
모델별 캐시 용량을 설명하는 간단한 계산은 다음과 같다. Meta가 공개한 Llama 3.1 8B 기본 설정은 층 32개, KV 헤드 8개, 모델 차원 4,096, Query 헤드 32개다. 헤드 차원은 4,096 ÷ 32 = 128이다. BF16에서 K와 V를 각각 2바이트로 저장하면 32층 × K/V 2 × KV 헤드 8 × 헤드 차원 128 × 원소 2바이트 = 토큰마다 131,072바이트, 즉 128KiB다. 131,072개 토큰이면 캐시만 16GiB다. 가중치와 작업 공간, 여유 용량은 별도다. 서비스 용량을 추정할 때는 여기에 모델 버전과 실제 KV 정밀도, 캐시 구현과 동시 요청 수를 반영한다. Meta 모델 설정
KV 재사용, 요청 수용, 워커 확장
KV 캐시는 이미 처리한 토큰의 어텐션 상태를 재사용하기 위한 데이터다. KV-aware router는 같은 접두부의 캐시를 가진 워커를 선호해 prefill 계산을 줄일 수 있다. 캐시가 많은 워커가 바쁘면 대기 비용도 고려해야 한다.
Dynamo v1.5.1 라우터 설정 문서는 캐시 중복에 주는 가점과 활성 부하를 함께 조정하는 방법을 설명한다. 캐시 적중률, 워커별 활성 부하, TTFT와 ITL을 함께 봐야 라우팅 변경의 효과를 읽을 수 있다. 구체적인 플래그와 기본값은 사용 중인 버전 문서에 맞춘다.
세 가지 제어는 담당하는 문제가 다르다.
| 계층 | 결정 | 확인할 결과 |
|---|---|---|
| 라우팅 | 어느 워커로 보낼지 | 캐시 재사용과 부하 쏠림, 대기 시간 |
| Admission control | 지금 받아들일지, 대기시키거나 거절할지 | 큐 길이, 시간 예산, 거절률과 수용한 요청의 지연 |
| Autoscaling | 워커를 얼마나 늘리고 줄일지 | prefill과 decode의 부하, 준비 시간, GPU 사용량 |
Planner는 부하 또는 지연 목표를 이용해 워커 수를 조정한다. Grove는 역할이 다른 추론 구성요소들의 구조와 생명주기를 Kubernetes에서 표현한다. 요청 수용과 워커 확장은 반응 시간도 다르므로, 과부하 경계에서의 제어를 확장 기능 하나로 대체할 수는 없다.
공통 접두부 캐시의 색인과 퇴출
KV prefix caching은 같은 입력 접두부의 계산을 다시 쓰게 한다. vLLM의 설계는 각 토큰 블록 해시에 앞 블록의 해시와 현재 블록 토큰을 연결하고, 블록 전체가 일치할 때 재사용한다. LoRA나 멀티모달 입력, cache salt 등 모델이나 사용자 경계를 가르는 조건도 일치해야 한다. 재사용 범위는 동일한 앞 문맥과 추가 키 조건을 가진 토큰 블록이다. vLLM APC 설계
SGLang의 RadixAttention은 접두부를 radix tree 구조로 색인한다. 공통 구간은 공유하고 입력이 달라지는 지점에서 분기하므로 새 요청에서 일치하는 가장 긴 접두부를 찾는다. 메모리를 비울 때는 참조 중인 블록을 지키고, 자식이 없는 말단을 최근 사용 시점에 따라 퇴출하는 방식으로 공유 부모를 보존한다. HiCache 같은 계층 캐시는 GPU 바깥의 CPU 메모리나 저장 장치까지 사용할 수 있다. 같은 token prefix가 있고 낮은 계층에서 불러오는 비용보다 재계산 비용이 클 때 이득을 낼 수 있다. SGLang HiCache 안내
서로 다른 접두부의 요청이 캐시 용량보다 번갈아 많이 도착하면 앞서 계산한 접두부가 밀려나고 같은 계산이 반복되는 prefix thrashing이 생긴다. 같은 접두부를 가진 요청을 먼저 묶으면 hit rate를 높일 수 있지만, 다른 요청을 오래 기다리게 해 공정성과 지연 목표를 해칠 수 있다. SGLang 논문의 정리 3.1은 미리 주어진 요청 배치에서 캐시가 가장 긴 요청을 담을 수 있는 조건을 둔다. 이 조건에서 깊이 우선 순서와 longest-shared-prefix-first 순서가 최적 캐시 적중률을 얻는다. 온라인 요청에서는 도착과 출력 길이 때문에 순서가 달라져 오래 기다린 요청의 우선순위를 함께 조정해야 한다. 벤치마크의 평균 96%는 각 벤치마크의 최적 캐시 적중률에 견준 값이다. 최대 6.4배 처리량 개선은 당시 비교 대상과 여러 최적화를 합친 측정 결과다. SGLang 논문
Prefill과 decode를 분리할 때의 비교
Aggregated serving에서는 같은 워커가 입력 처리와 생성을 맡는다. Disaggregated serving에서는 prefill과 decode 워커를 나누고, 계산한 KV 상태를 전달한다. 독립적인 용량 조절과 역할별 최적화가 장점이며, KV 전송과 통신 경로가 추가 비용이 된다.
비교할 때는 모델과 정밀도, 입력 및 출력 길이 분포, 요청률, GPU 종류와 수, 네트워크를 맞춘다. 분리 전후의 TTFT만으로 끝내지 말고 출력 중 지연과 총 처리량, 전송 비용을 함께 본다. 캐시 재사용이 많은 트래픽과 긴 입력 위주의 트래픽에서도 결과가 달라질 수 있다. Dynamo 분리 서빙 문서
Goodput의 정의와 서비스 목표
Goodput은 설정한 서비스 지연 목표를 만족한 완료 요청의 처리량으로 읽는다. 요청량이 늘어 초당 완료 수가 높아져도 TTFT 또는 TPOT 기준을 넘긴 요청이 많다면 goodput은 낮을 수 있다. TTFT의 시작과 종료 지점과 TPOT 또는 ITL의 계산 방법, p50/p99 범위, 요청과 출력 길이를 함께 기록해야 엔진이나 배치를 비교할 수 있다. DistServe 논문은 TTFT와 TPOT 조건을 함께 충족하는 요청을 기준으로 서빙 구성의 처리량을 비교한다. 논문에 등장하는 최대 배율은 특정 하드웨어, 부하, 지연 목표와 기준 서빙 구성을 전제로 한다. DistServe 논문
Speculative decoding의 결과를 읽는 법
후보를 만드는 proposer와 그 후보를 검증하는 target 모델을 구분한다. 여러 후보가 검증을 통과하면 한 번의 target 실행에서 여러 출력 토큰을 확정할 수 있다. 후보 생성에도 비용이 있으므로, 수락 길이와 검증 비용을 함께 측정해야 한다.
vLLM 공식 문서는 제안 방식과 검증 설정, 지원 조건을 정리한다. 표준 rejection sampler를 통한 분포 보존과 검증을 완화하는 변형은 구분해야 한다. 특정 모델의 성능 향상을 재사용할 때는 draft 모델, target 모델, 병렬화와 엔진 버전, 입력 길이와 부하를 함께 남긴다.
Attention의 메모리 이동을 줄이는 FlashAttention
FlashAttention은 attention 계산에서 중간 점수 행렬을 GPU의 큰 메모리에 반복해서 쓰고 읽는 비용을 줄인다. Query, Key, Value를 타일로 나누어 빠른 on-chip 메모리로 불러오고, online softmax에 필요한 최대값과 누적합을 유지해 타일을 처리한다. 어텐션의 수학적 계산 결과는 그대로 둔 채 HBM과 빠른 메모리 사이의 이동량을 줄이는 exact attention이다. FlashAttention 논문
PagedAttention은 요청의 KV 블록이 놓인 위치를 관리하는 저장 구조이고 FlashAttention은 어텐션 계산 중 메모리 이동을 줄이는 커널 알고리즘이므로 두 기법의 역할은 다르다. 둘을 함께 사용할 때는 페이지 블록을 읽는 주소와 커널이 계산에 기대하는 형태를 맞춘 구현이 필요하다.
시뮬레이션과 실제 검증
NVIDIA AISimulate는 GPU 서빙 클러스터를 띄우기 전에 성능을 예측하고 배포 구성을 탐색하는 도구다. 저장소는 후보 구성을 실제 목표 하드웨어에서 벤치마크한 뒤 용량과 SLA를 결정하도록 명시한다. 예측값은 탐색 범위를 줄이는 데 사용하고, 실측값과 같은 열에 표시할 때는 구분한다.
AIConfigurator를 쓰던 자료를 따라갈 경우 AIConfigurator 저장소와 AISimulate의 이전 안내를 함께 확인한다. 2026년 10월 확인한 저장소는 AISimulate로의 전환을 안내하고 있다. 이름만 보고 오래된 예제와 최신 CLI를 섞지 않는다.
토스 SlashLive 사례의 수치와 범위
토스 챌린저스의 발표는 2026년 10월 14일 발표, 10월 19일 업로드로 확인된다. 다음은 발표에 제시된 구성의 측정 결과다.
| 사례 | 발표값 | 해석 범위 |
|---|---|---|
| TTS RTF | 1.40 → 0.31 | 해당 기존 vLLM-Omni 구성과 자체 엔진 비교 |
| TTS TTFA | 6,305ms → 107ms | 약 58.9배의 지연 감소, 발표에서는 약 60배로 표현 |
| AR 추론 스텝의 비용 | 프레임워크 약 104ms, GPU 약 5ms | TTFA 전체가 아니라 표시된 스텝의 프로파일링 |
| TTS 처리량 | 27K 요청/분 | 단위 시간당 요청 수 |
| Gemma 4 26B | TTFT p50 42.1ms, 출력 503.25 tokens/s | 발표의 내부 구성, 외부 서비스와의 통제된 비교로 사용하지 않음 |
| GLM-5.3-Flash 최적화 | 유저당 생성 속도 5.2배, 전체 처리량 2.2배 | 발표의 전후 구성 비교, 단일 기법만의 효과로 분리하지 않음 |
수치 확인 구간은 4:30 기존 TTS, 5:20 병목, 6:45 최적화 결과, 12:40 Gemma, 14:05 GLM다.
다른 구성과 비교하려면 GPU와 엔진 버전, 정밀도, 요청 길이와 부하, 측정 위치를 추가로 맞춰야 한다. 사례에서 재사용하기 좋은 부분은 수치 자체보다, 프로파일링으로 수정할 계층을 좁히고 실제 서비스 목표로 개선을 판정하는 절차다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/llm-wiki/ai-serving-latency-capacity-cuda-kv-source-guide/index.md'