 Readiz
루프 트랜스포머는 같은 가중치로 어떻게 더 깊게 계산할까
같은 층을 반복해 토큰 내부의 계산 깊이를 늘리는 원리와, 성능과 비용 비교에서 놓치기 쉬운 조건을 정리합니다.
글 관리 · 공개 범위언어 모델을 키우는 방법은 모델의 가중치와 학습 데이터를 늘리는 것만이 아니다. 답을 만들기 전에 추론 문장을 더 쓰게 할 수도 있고, 한 토큰을 출력하는 동안 모델 안에서 같은 계산 블록을 여러 번 돌게 할 수도 있다. 마지막 방법이 루프 트랜스포머다. 가중치 수를 크게 늘리지 않고 계산 단계를 추가한다는 점이 핵심이다. 파라미터 수와 계산 깊이라는 서로 다른 자원을 다시 배분하는 설계다.
가중치를 늘리지 않고 계산을 반복한다
일반적인 트랜스포머는 서로 다른 층마다 별도의 가중치를 둔다. 네 층 모델이라면 층 1부터 층 4까지 각자 다른 규칙을 가진다. 입력이 그 층들을 순서대로 통과하며 표현을 바꾼다.
루프 모델에서는 여러 층의 묶음을 공유 코어로 정해 재사용한다. 예를 들어 고유한 층 네 개를 한 번씩 통과하는 대신, 가중치가 서로 다른 두 층을 두 번 통과할 수 있다. 두 방식은 계산을 네 번 수행하지만 저장하는 층 가중치는 네 세트와 두 세트로 다르다. 반복할 때마다 들어가는 상태는 달라지므로 같은 가중치가 매번 같은 출력을 내는 것도 아니다.
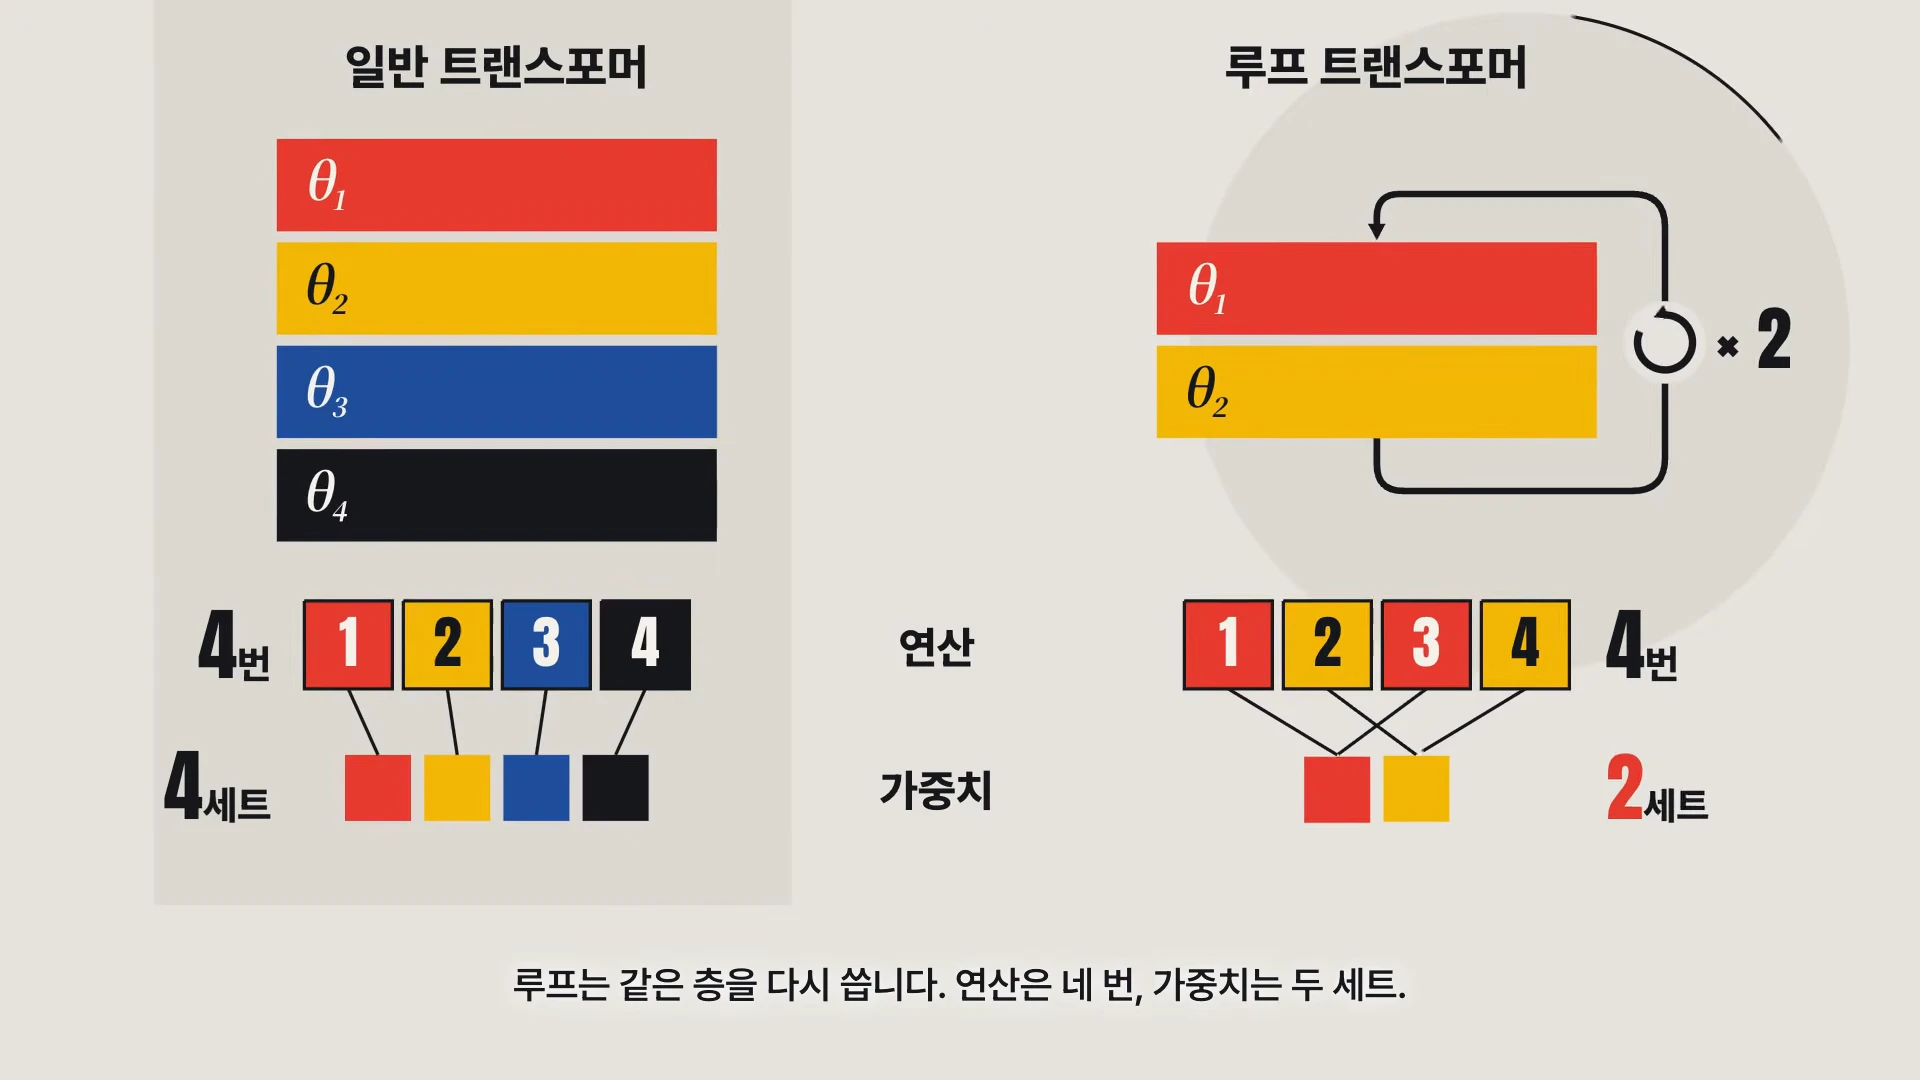
일반 모델은 네 층에 네 가중치 묶음을 쓰고, 루프 모델은 두 묶음을 두 번 사용. Robin, 0:54.5
Huginn처럼 입력을 먼저 처리하는 프렐류드, 반복하는 코어, 출력을 정리하는 코다로 나눈 설계도 있다. 이 모델은 프렐류드와 코다는 한 번 쓰고 코어를 반복한다. Huginn 연구는 반복 블록을 중심으로 한 35억 파라미터 모델을 설명한다. 이 모델은 8,000억 토큰으로 학습됐고 코어를 평균 32회 반복했다.
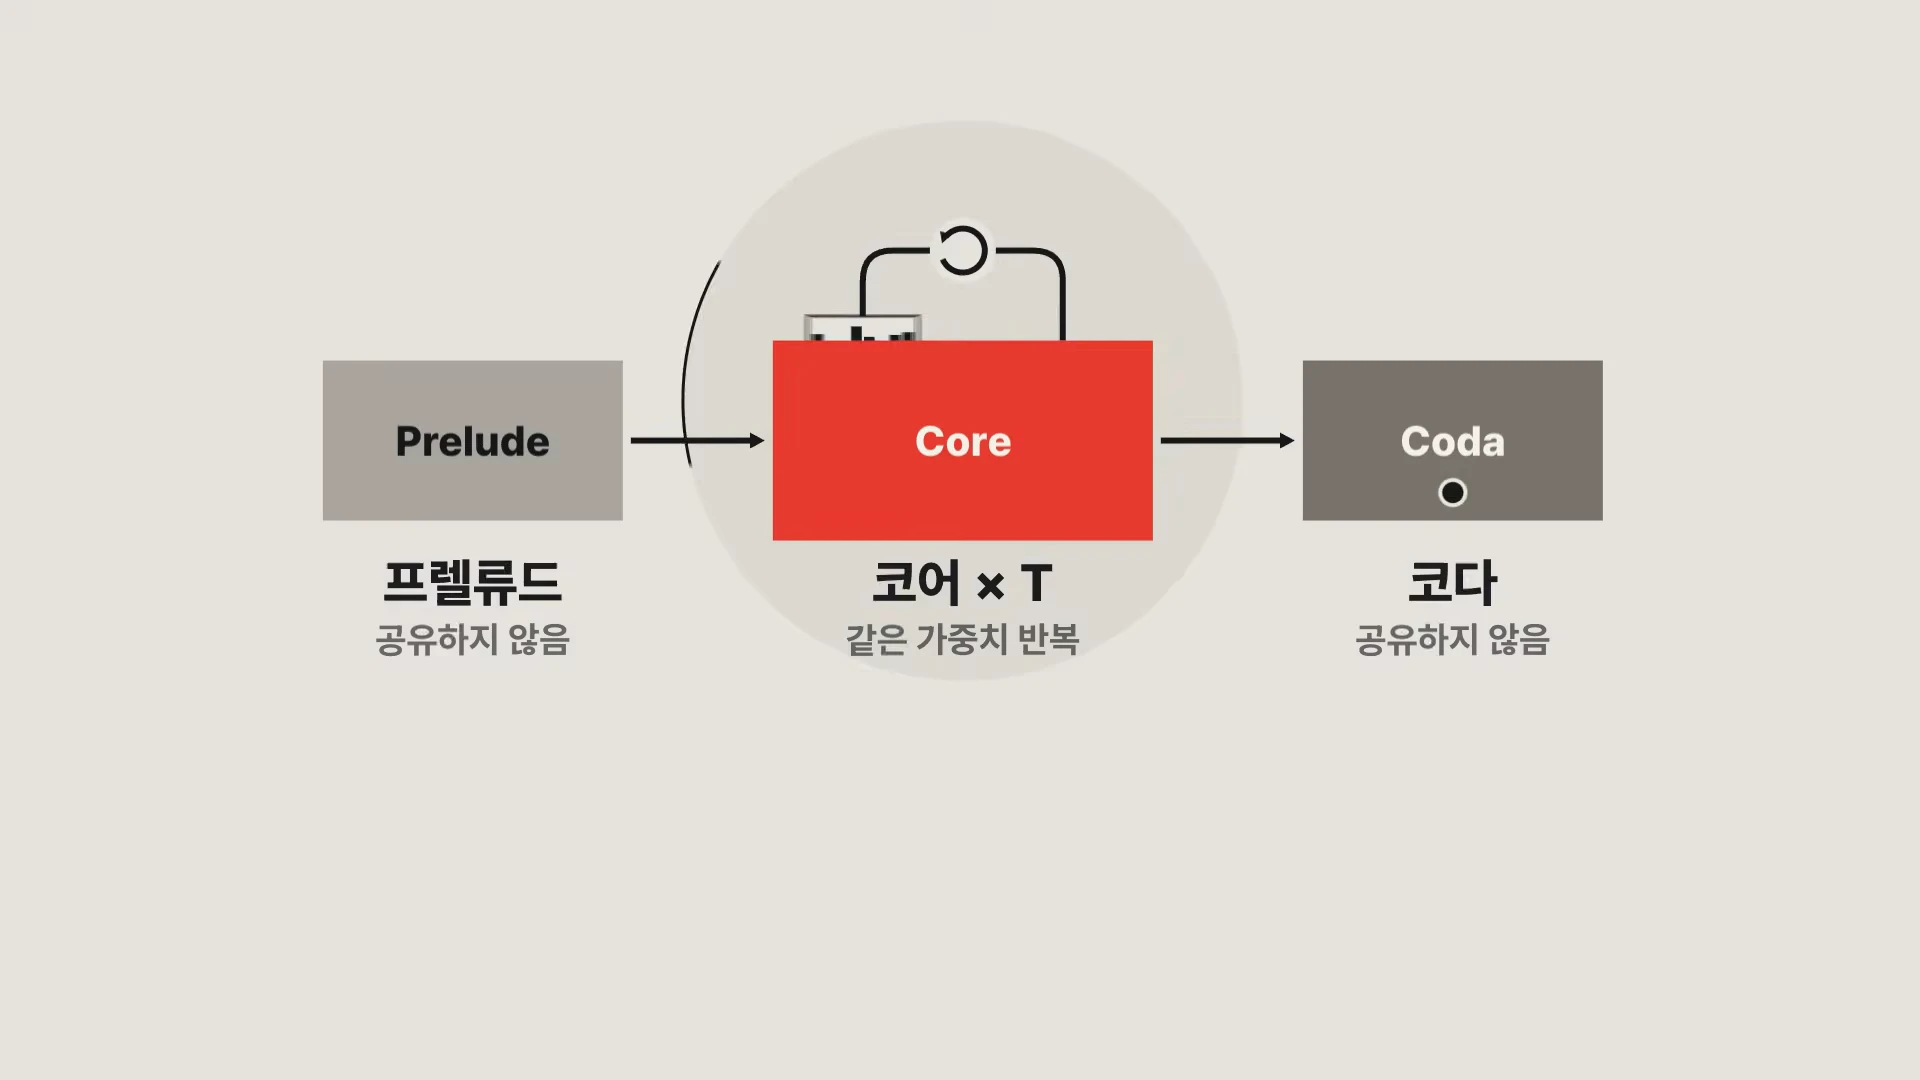
입력 프렐류드에서 코어를 반복한 뒤 코다로 이어지는 구성. Robin, 1:00
핵심은 반복 횟수만큼 파라미터를 복제하는 것이 아니라, 현재 상태에 같은 함수를 다시 적용한다는 데 있다. 단순화해 쓰면 다음과 같다.
여기서 는 입력, 는 코어를 번 지난 뒤의 내부 상태, 는 반복마다 공유하는 가중치다. 를 늘리면 가중치 수는 그대로인 채 상태를 변환하는 연산이 더 수행된다. 그래서 파라미터 규모와 한 토큰에 쓰는 계산량을 따로 살펴야 한다.
더 깊은 반복이 도움이 되는 조건
층을 한 번 더 통과한 상태에는 앞 단계의 계산 결과가 들어 있다. 새 층을 더해 다음 계산 규칙을 추가하는 대신, 이미 학습한 코어로 중간 상태를 거듭 다듬는 셈이다. 데이터에서 얻은 지식이 반복만으로 새로 저장되는 것은 아니다. 모델이 가진 정보를 더 많은 계산으로 조합할 여지가 생긴다.
Bansal 등의 2022년 연구는 작은 미로에서 학습한 순환 합성곱 신경망을 반복시켜 더 큰 미로 문제를 푼 사례를 보였다. 영상에는 9×9 미로에서 30회 반복해 학습하고, 801×801 크기의 특정 미로에서 10,000회 반복해 푸는 예가 나온다. 원 논문 그림 19의 단일 미로 사례는 반복 횟수를 크게 늘려 계산을 이어가는 방식을 보여준다.
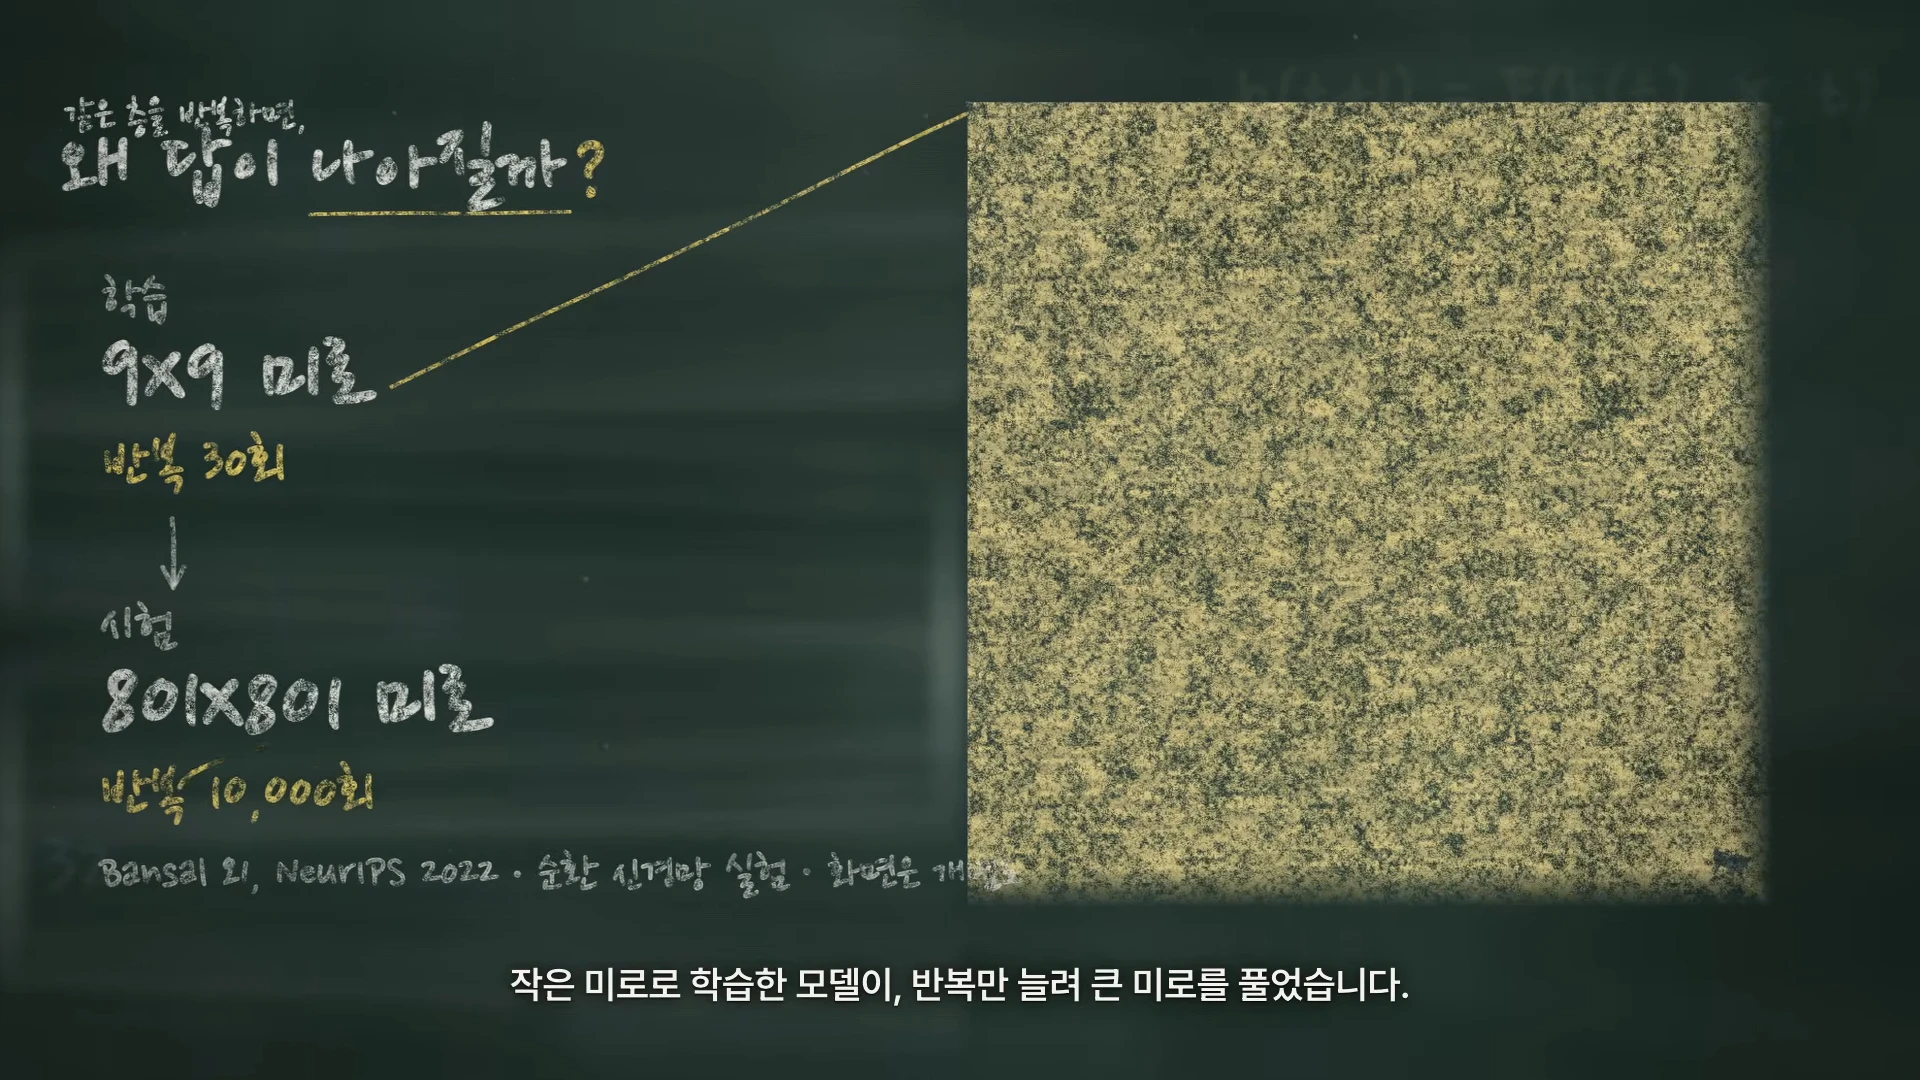
영상에서 소개한 미로 예시. 2022년 연구의 단일 사례이며 순환 합성곱 모델 결과. Robin, 1:45.5
추론 중 반복 횟수를 입력이나 토큰의 난도에 따라 바꾸는 설계도 있다. 모델이 충분히 계산했다고 판단하면 일찍 멈추고, 더 복잡한 상태에는 반복을 추가한다. 영상은 을 계산하는 예에서 쉬운 중간 단계와 어려운 단계를 구분해 설명한다. 이런 적응형 종료는 계산을 필요한 곳에 집중시키려는 방법이다. 반복을 끝내는 규칙은 모델과 추론 엔진의 구현에 달려 있다. 고정 횟수로 코어를 실행하는 방식과 토큰별 종료를 적용하는 방식이 모두 있다.
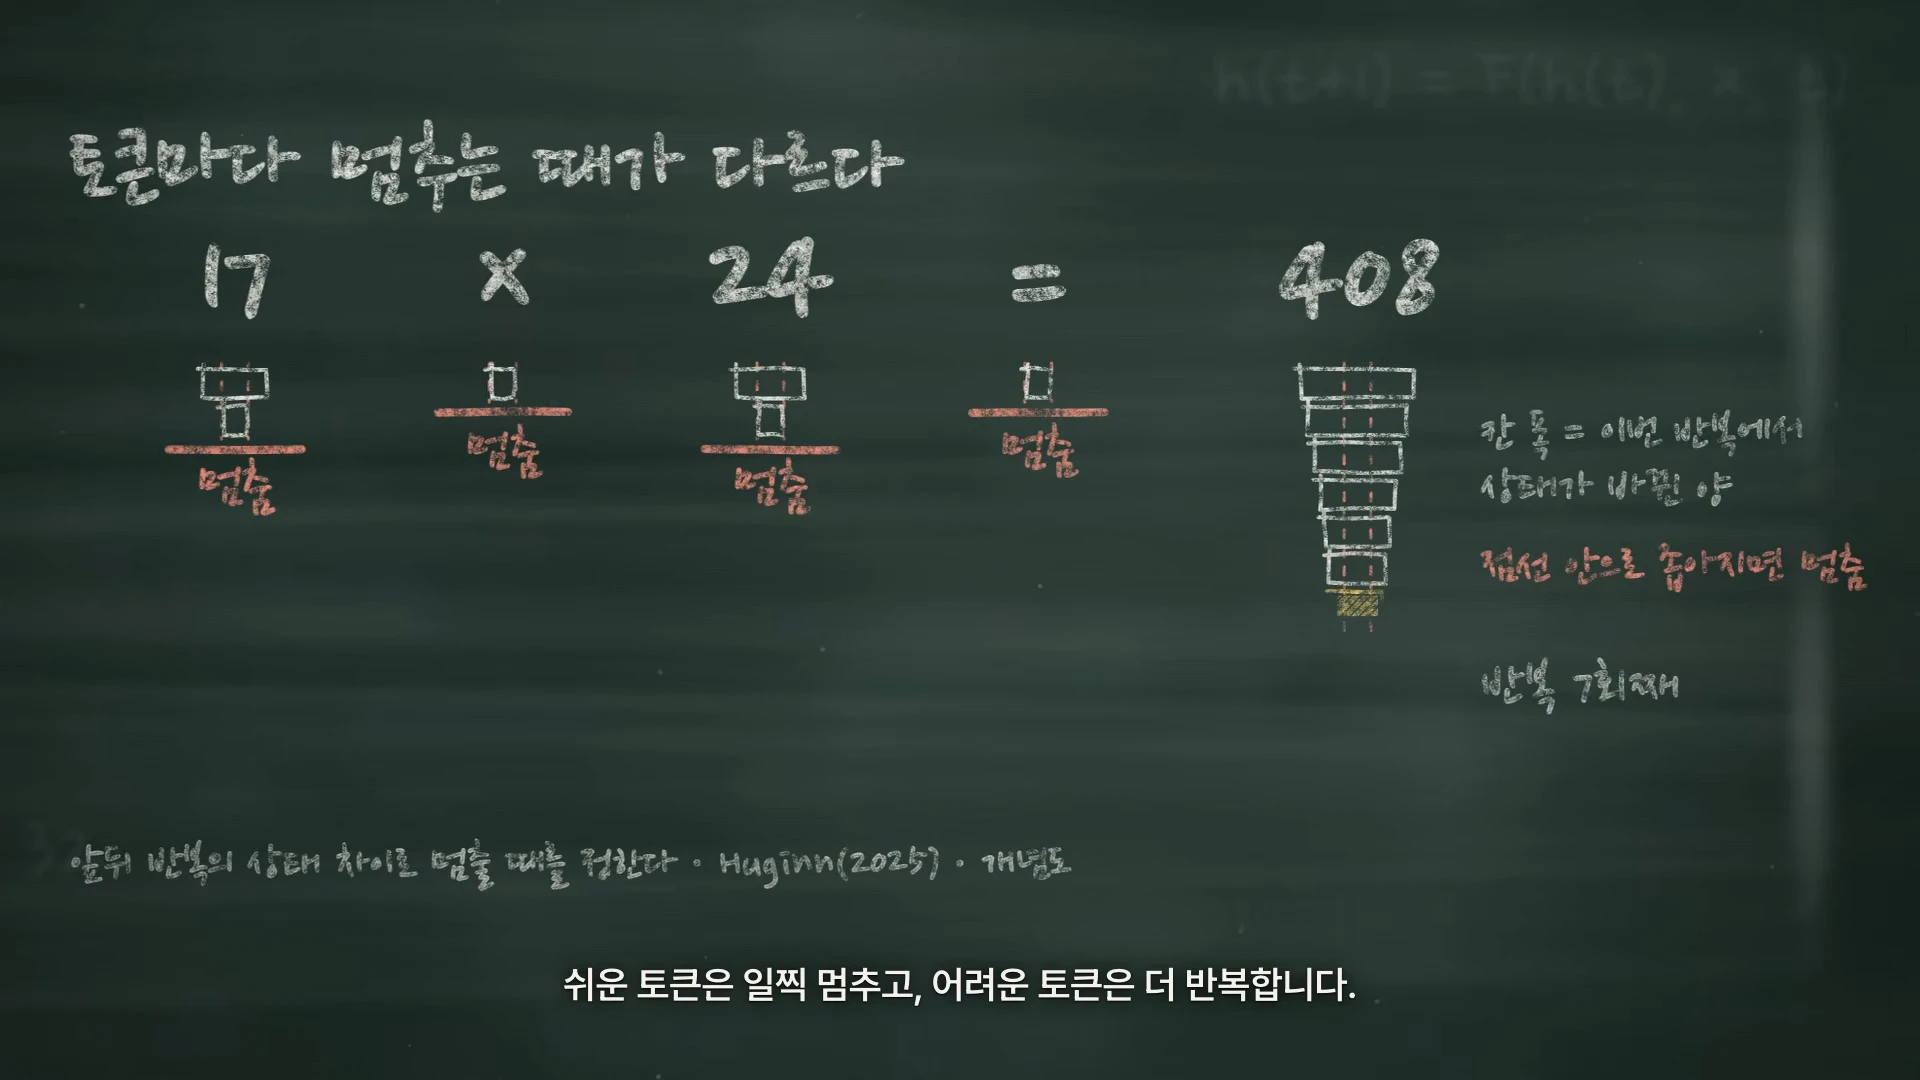
토큰이나 계산 단계에 따라 반복을 일찍 끝내는 적응형 종료의 설명 예시. Robin, 2:03
CoT와 내부 반복은 계산을 이어가는 위치가 다르다
Chain of Thought(CoT)는 풀이 과정을 텍스트 토큰으로 출력한다. “17에 20을 곱하고, 17에 4를 곱한 뒤 더한다”처럼 중간 단계를 문장으로 남길 수 있다. 루프 트랜스포머는 계산 단계를 모델 내부 상태에서 반복한다. 중간 단계를 내부 상태에서 이어가면서, 토큰 하나를 정하는 데 쓰는 연산을 추가한다.
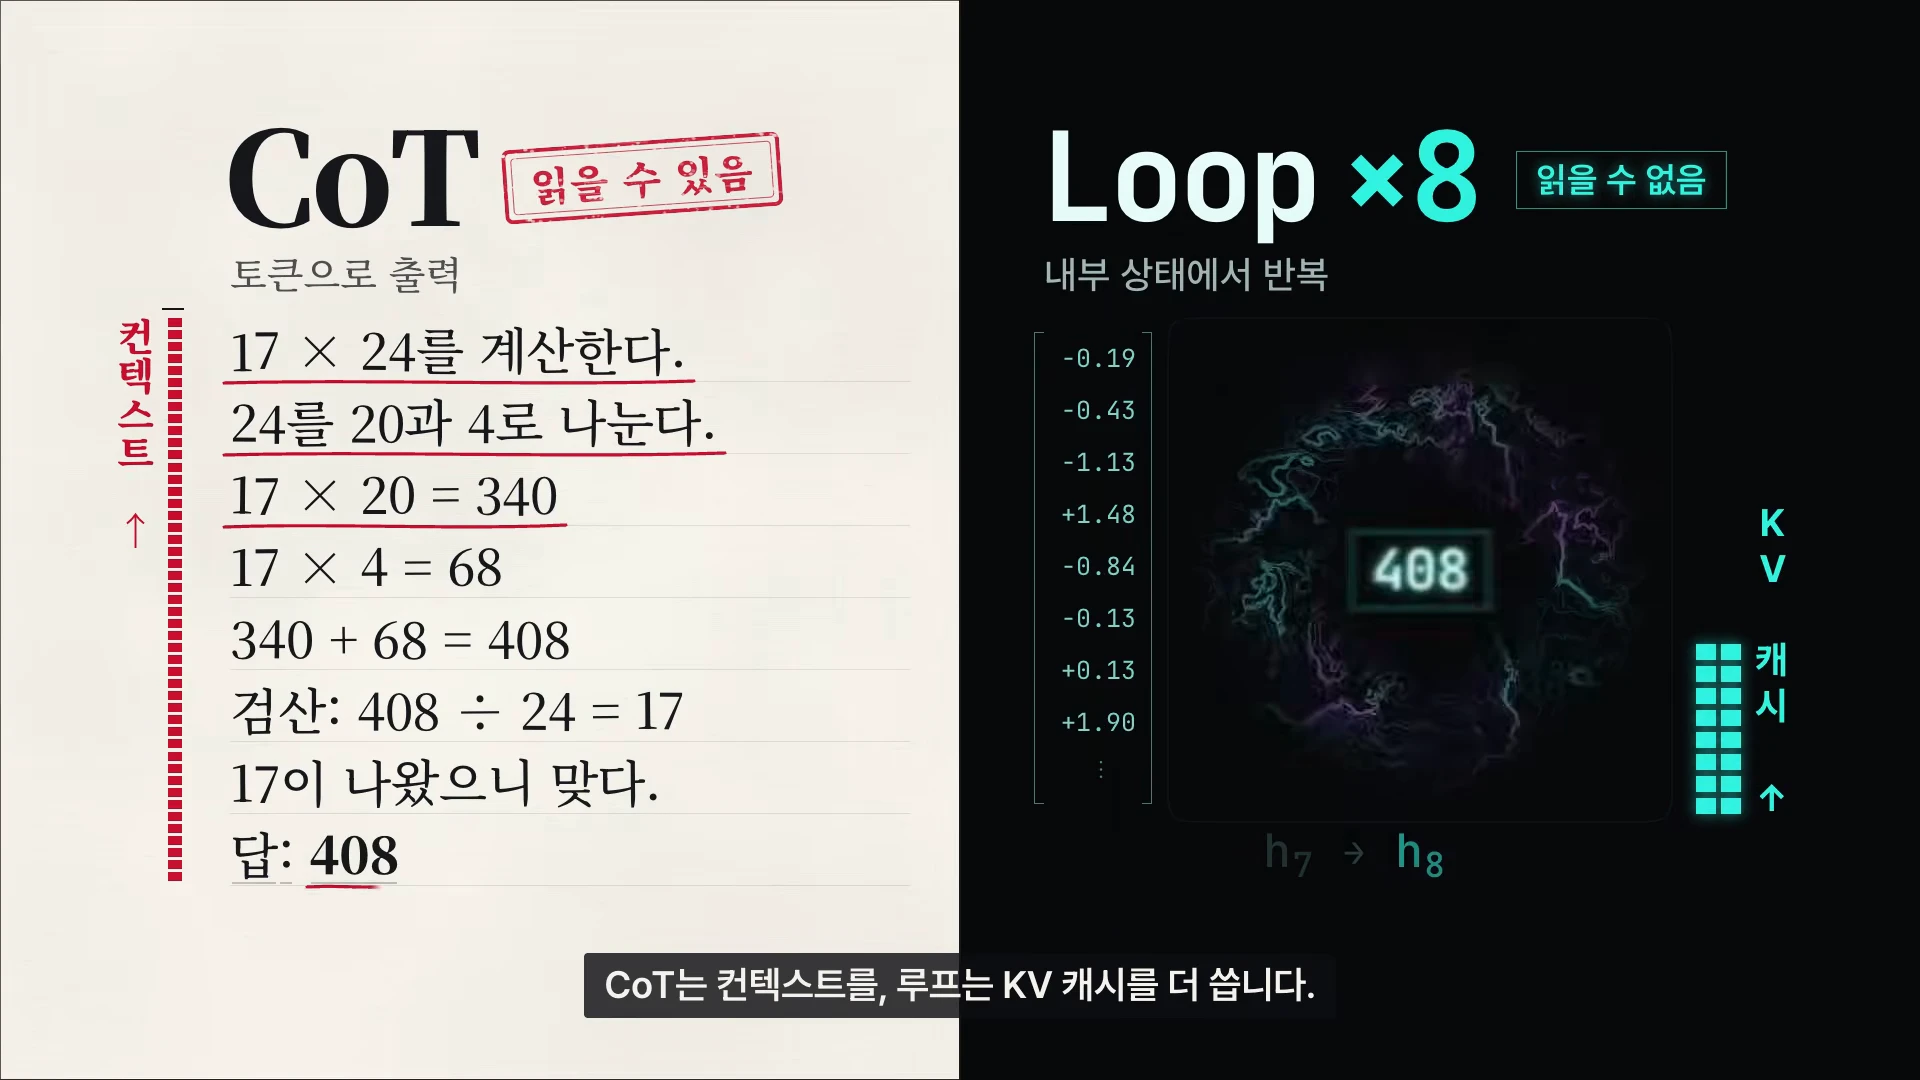
CoT는 풀이를 토큰으로 표현하고 루프는 내부 상태를 반복해서 갱신. Robin, 2:29.5
CoT도 이전 토큰의 key와 value를 저장하는 KV 캐시를 사용한다. 루프 모델도 입력 문맥을 처리해야 하므로 문맥의 비용이 사라지는 것은 아니다. 내부 반복에서 어텐션을 계산하는 구조에서는 반복별 상태나 key/value가 추가 메모리를 차지할 수 있다. 캐시를 공유하거나 압축하는 방식과 구체적인 구현에 따라 사용량이 달라진다. CoT의 긴 출력은 토큰과 문맥을 늘리고, 루프의 깊이는 토큰마다 내부 계산을 늘린다. 두 방식을 함께 쓰는 것도 가능하다.
숫자는 무엇을 세었는지 먼저 봐야 한다
Universal Transformer는 2018년에 위치별 종료와 반복 계산을 제안했다. 이후 공개된 루프 언어 모델과 학습 토큰 규모는 커졌다. 2025년 공개된 Huginn은 35억 파라미터 모델을 8,000억 학습 토큰으로 학습한 사례를 보고했다. 같은 해 공개된 Ouro는 서로 다른 크기 설정으로 7조 7,000억 토큰을 학습했다. 2026년 공개된 Nanbeige4.2-3B는 임베딩을 제외한 30억 파라미터 모델과 28조 사전학습 토큰을 설명한다. 여기서 토큰 수는 각 모델의 학습 데이터 규모다.
2026년 10월 6일 기준 공개 서베이는 7,323개 후보에서 핵심 논문 557편을 추렸고, 선정된 연구의 약 60%가 직전 12개월에 나왔다고 집계했다. 동료심사 전 공개된 서베이의 검색과 선별 범위 안에서 연구가 얼마나 빠르게 늘었는지 보여주는 수치다.
효율 비교에서는 무엇을 같게 맞췄는지가 결론을 바꾼다. 파라미터 수를 맞추면 반복 모델은 더 많은 계산을 써 더 낮은 손실을 얻을 수 있다. 계산량을 맞추면 같은 예산 안에서 새 가중치 층과 반복 횟수를 어떻게 배분했는지가 중요해진다. 학습 토큰 수만 맞춘 비교도 실제 추론 연산이나 생성 속도가 같다는 뜻은 아니다. 모델 크기, 학습량, 계산 예산, 평가 과제 중 무엇을 고정했는지 확인해야 한다.
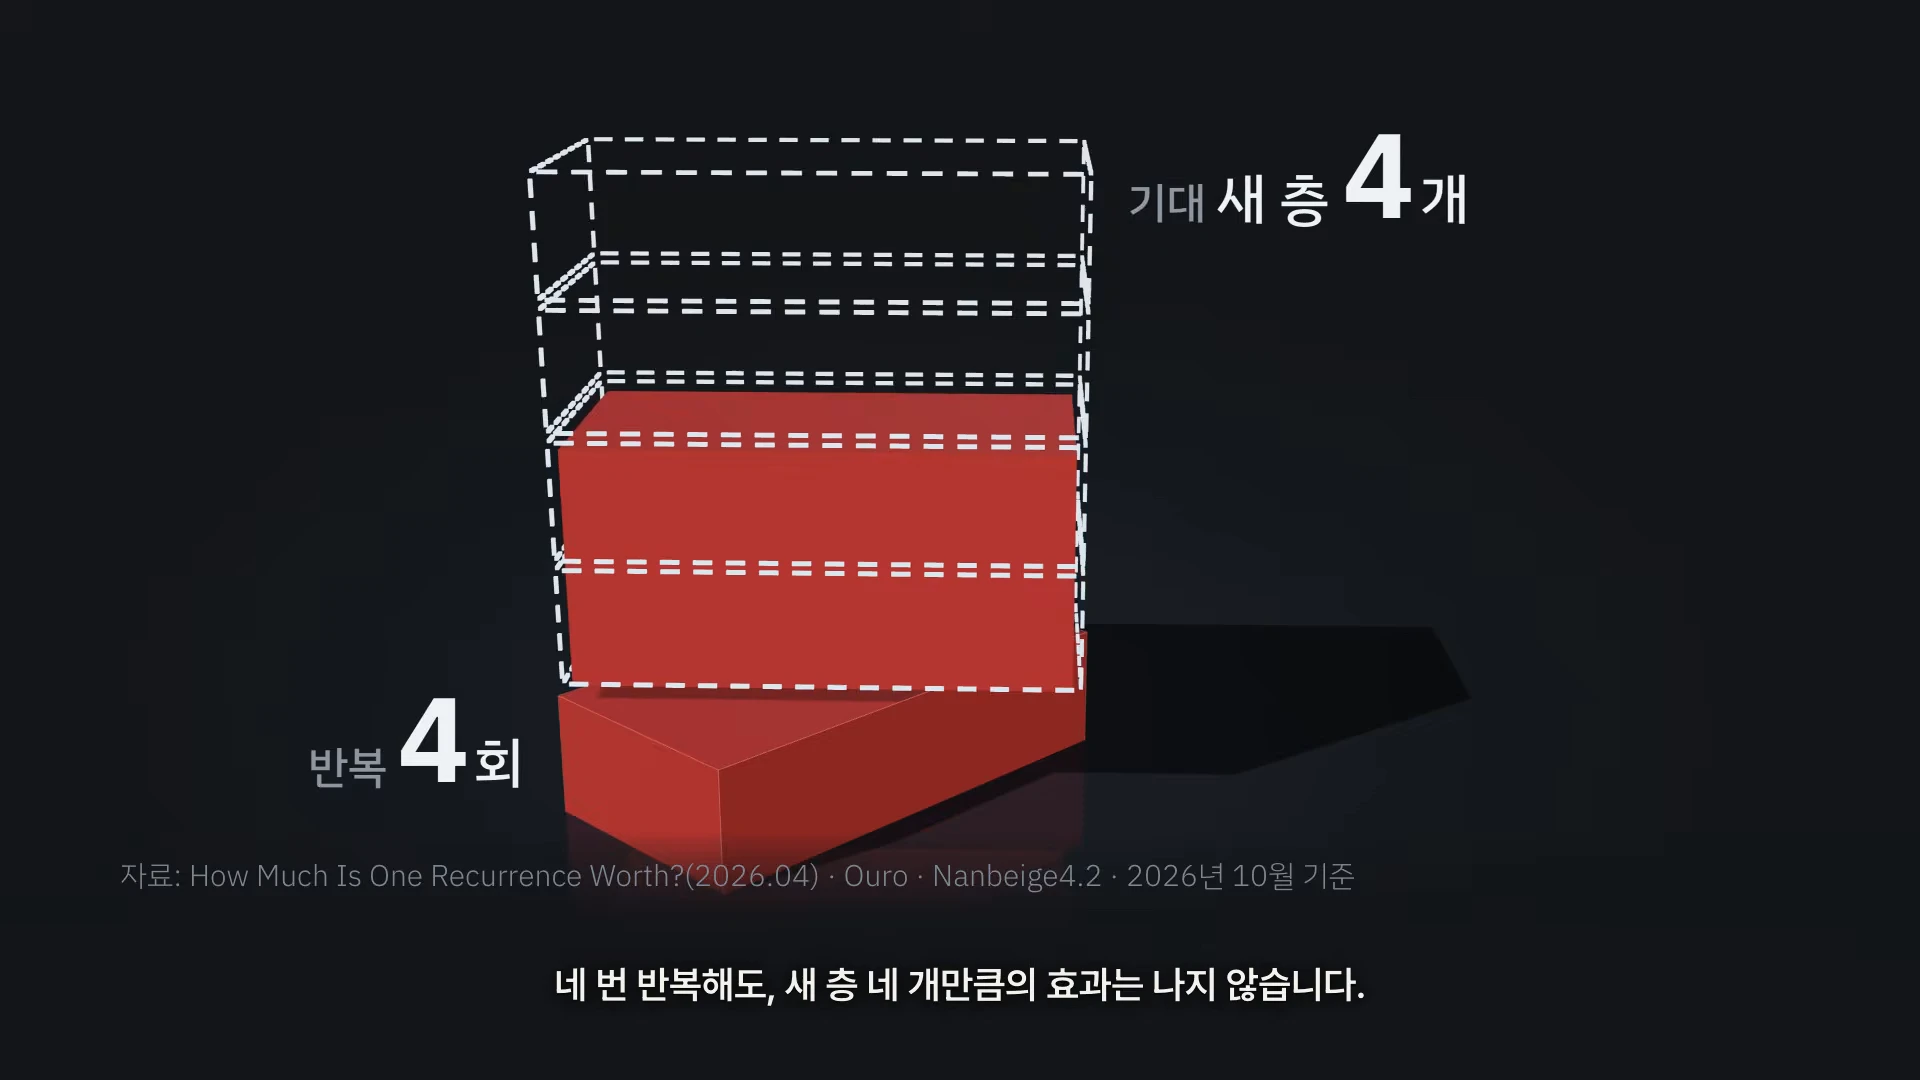
반복 깊이와 새 층의 효과를 비교한 영상 도식. Robin, 3:06
반복 모델 스케일링 연구의 2026년 10월 28일 v4에는 이를 보여주는 환산 예시가 있다. 고유 파라미터가 약 4.1억 개(410M)인 4회 반복 모델은, 스케일링 법칙이 예측하는 검증 손실에서 약 5.8억 개(580M)인 일반 모델과 비슷하다. 같은 폭과 유효 깊이를 기준으로 하면 토큰당 학습 연산은 약 10억 파라미터(1B) 일반 모델 수준이다. 저장하는 가중치는 줄지만, 반복에 드는 계산은 계속 지불하는 구조다. 이 수치는 논문의 적합식과 구조 비율로 산출한 예시이며 실제 GPU 지연이나 운영비는 별도로 측정할 지표다.
학습 때보다 추론 반복을 늘릴 때 성능이 어떻게 바뀌는지도 과제와 모델에 따라 다르다. 앞의 미로 연구는 학습 때 30회보다 훨씬 많은 10,000회 반복으로 단일 예제를 풀었다. Huginn에서도 추론 반복 횟수와 점수의 관계가 벤치마크에 따라 달랐다. 서베이가 정리한 수학 과제에는 학습 중 반복보다 추론 반복을 늘렸을 때 성능이 낮아진 결과도 있다. 반복 횟수와 성능의 관계는 해당 모델과 평가 과제의 조건을 함께 놓고 읽어야 한다.
영상은 일부 대형 모델이 두 번 반복을 선택한 사례를 소개한다. 이는 해당 모델의 계산 제약과 성능 목표에 맞춘 운용점이다. 반복마다 계산량이 늘어나므로 정확도, 지연 시간, 메모리, 배치 크기와 하드웨어 처리량을 함께 비교해야 한다.
내부 추론을 어떻게 확인할까
내부 상태에서 계산을 더 수행하면 텍스트로 남는 추론 흔적이 짧아질 수 있다. 이를 다룬 감시 가능성 연구가 나왔다. 2026년 10월 공개된 감시성 연구는 8개 과제의 스트레스 테스트 중 일부에서 반복 깊이가 커질 때 CoT 감시성이 낮아지는 사례를 보고했다. 동시에 모델 크기와 깊이를 맞춘 일반 모델과 비교하면 루프 모델이 체계적으로 더 나쁘다는 증거는 찾지 못했다. 반복 깊이가 텍스트로 드러나는 정보와 감시 결과를 어떻게 바꾸는지, 과제와 비교 모델을 맞춰 평가한 결과다.
영상은 2026년 9월 프론티어 모델에 이 방식이 쓰였다는 보도를 언급한다. 이 대목의 근거는 영상이 소개한 보도에 한정된다. Robin, 3:27
루프 트랜스포머의 장점은 적은 가중치로 더 깊은 계산을 구성할 수 있다는 점이다. 그 대가로 추론 연산과 반복 상태 관리가 필요하다. 성능 비교에서는 파라미터만 보거나 반복 횟수만 세면 부족하다. 같은 데이터와 계산 예산에서 어떤 과제를 얼마나 잘 풀었는지, 그 결과를 얻는 동안 지연과 메모리를 얼마나 썼는지도 함께 살펴야 한다. 같은 층을 반복한다는 발상은 계산 깊이를 조절하는 유용한 선택지지만, 실제 이점은 이 조건을 맞춰 본 비교에서 결정된다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/records/loop-transformer-shared-weights-deeper-computation/index.md'