 Readiz
그로킹과 기계론적 해석가능성: 푸리에 회로와 줄바꿈 매니폴드
Power와 Nanda의 그로킹 연구, Claude 3.5 Haiku의 문자 수 표현과 QK twist를 읽는 원문, 실험 조건과 해석 기준.
글 관리 · 공개 범위그로킹(grokking)은 훈련 예제에 과적합한 뒤 오랜 학습을 거쳐 시험 예제로 일반화하는 현상이다. 이 문서는 작은 모듈러 덧셈 모델의 푸리에 회로와, Claude 3.5 Haiku의 줄바꿈 회로를 조사할 때 사용할 원문과 해석 기준을 정리한다.
두 사례는 모델의 내부 표현을 관찰하고, 실제 계산과 연결한 뒤, 그 표현에 개입해 설명을 검증하는 기계론적 해석가능성(mechanistic interpretability)의 자료다.
원문과 질문
| 자료 | 공개 시점 | 다시 찾아볼 질문 |
|---|---|---|
| Power 외, Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets | 2022-01-06 | 훈련 정확도가 높아진 뒤 일반화가 얼마나 늦게 나타나는가 |
| Nanda 외, Progress measures for grokking via mechanistic interpretability | 초판 2023-01-12, 참조본 v3 2023-10-19 | 모델이 어떤 알고리즘을 배웠으며, 성능 정체 중 무엇이 변했는가 |
| Gurnee 외, When Models Manipulate Manifolds | 최초 2025-10-21, arXiv 2026-01-08 | 상용 모델이 문자 수와 줄 너비의 관계를 어떻게 계산하는가 |
원기관 PDF: Power, Nanda v3, Gurnee. Gurnee 논문의 저자는 Wes Gurnee, Emmanuel Ameisen, Isaac Kauvar, Julius Tarng, Adam Pearce, Chris Olah, Joshua Batson이다.
모듈러 덧셈 실험의 조건
Nanda 논문 3절의 대표 실험은 을 예측한다. 숫자 토큰은 0부터 112까지이며 입력은 a b = 형태다. 등호 위치에서 답을 읽는다.
| 항목 | 대표 실험 설정 |
|---|---|
| 입력 쌍 | 개 |
| 훈련/시험 분리 | 가능한 입력의 30%로 훈련, 나머지로 시험 |
| 모델 | 단층 ReLU 트랜스포머, LayerNorm 생략 |
| 임베딩 폭 | 128 |
| 어텐션 | 4개 헤드, 헤드별 폭 32 |
| MLP 숨은 폭 | 512 |
| 최적화 | AdamW, 전체 배치, 학습률 0.001, weight decay 1 |
| 학습 길이 | 40,000 에포크 |
논문은 약 1만 에포크 부근에서 일반화하는 대표 곡선을 제시한다. 실행 설정과 난수 시드에 따라 전환 시점과 주요 주파수는 달라진다. 훈련 정확도 100%와 크로스엔트로피 손실 0도 서로 다른 조건이다.
푸리에 회로의 계산
이라 두면, 임베딩은 입력 를 각 주파수의 사인과 코사인으로 표현한다. 어텐션과 MLP는 삼각함수 덧셈정리에 해당하는 조합을 만들어 와 를 계산한다. 출력부는 후보 마다 다음 항들을 합쳐 점수를 만든다.
정답에서는 각 주파수의 파동이 정렬되어 높은 점수를 낸다. 가중치와 활성값에 나타난 주기성, 출력 방향으로 투영한 결과, 뉴런의 삼각함수 근사와 제거 실험을 함께 근거로 삼는다. 정의와 유도는 3.1절과 4절을 참고한다.
주실험에서 임베딩의 유의한 주파수는 6개였고, 이후 계산에서 주로 사용한 것은 의 5개다. 주요 주파수를 제거하면 성능이 크게 떨어지고, 그 밖의 대부분의 주파수를 제거하면 성능이 유지되거나 소폭 좋아졌다. 프로브로 읽을 수 있는 정보와 실제 예측에 기여하는 정보의 관계를 확인할 때 쓸 근거다.
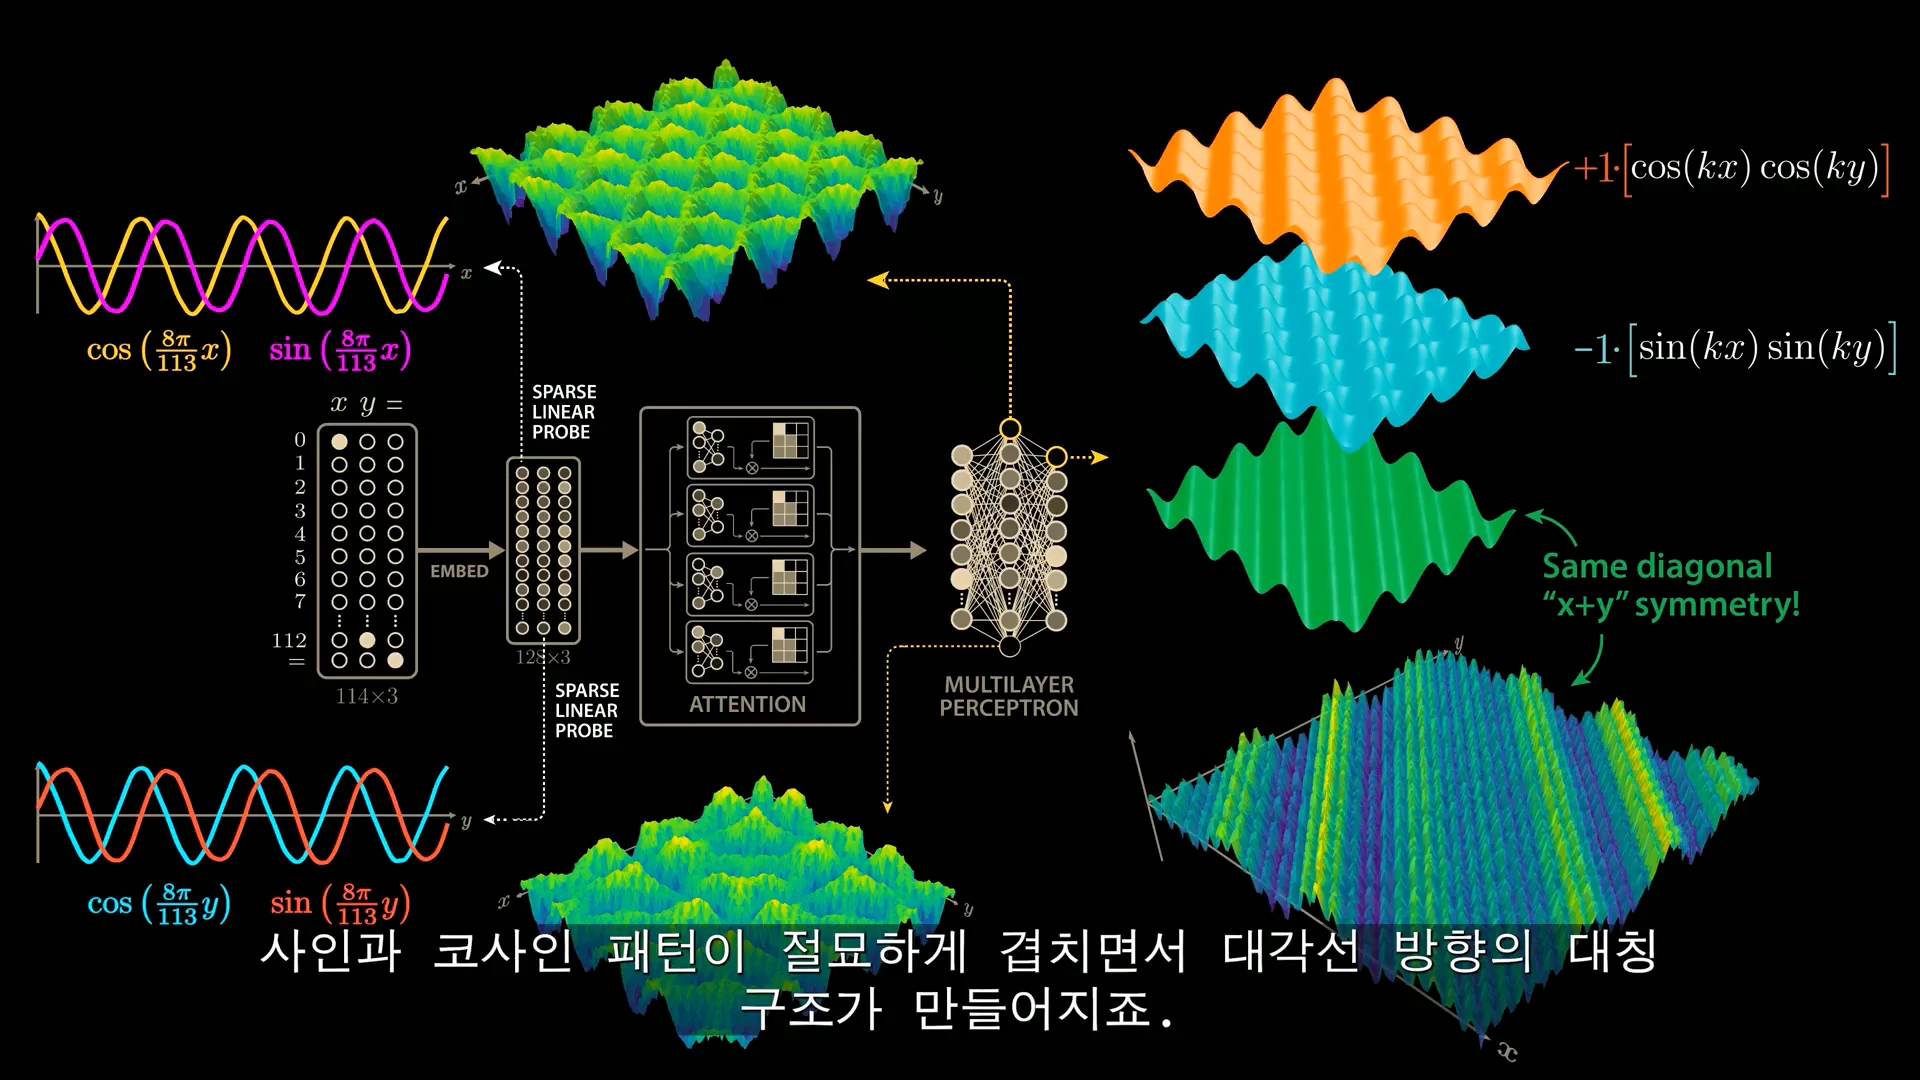
곱 형태의 두 파동을 조합해 합에 따른 대각선 구조를 만드는 과정. 웰츠랩스, 23:10
영상은 동일한 아이디어를 다른 구체적인 파형으로 설명한다. 영상의 을 논문 대표 실행의 주파수 목록에 섞지 않는다. 그림의 표기와 논문의 정수 주파수 번호도 각 문맥의 정의에 맞춰 읽는다.
학습이 진행되는지 읽는 두 손실
5.1절은 입력 두 축에 대한 로짓의 푸리에 성분을 조작해 진행 지표를 만든다.
- Restricted loss: 주요 주파수의 합에 해당하는 일반화 성분과 상수항만 남긴 뒤 손실을 잰다. 완성된 해법이 학습 중 얼마나 형성됐는지 보여준다.
- Excluded loss: 주요 주파수 성분을 제거한 뒤 훈련 손실을 잰다. 일반화 회로를 빼고도 훈련 데이터를 얼마나 설명할 수 있는지 본다.
논문은 암기, 회로 형성, 정리의 세 단계를 구분한다. 회로 형성 중 제한 손실은 개선되지만 시험 손실은 한동안 거의 움직이지 않는다. 주요 성분에 더 의존하면서 제외 손실은 올라가고, 이후 암기 성분이 약해지는 정리 단계에서 시험 성능이 크게 개선된다.
Weight decay가 더 작은 가중치로 훈련 예제를 설명하는 일반화 회로를 선호하도록 유도한다는 것이 연구진의 해석이다. 이 논문의 무규제 대조 실험에서는 그로킹이 나타나지 않았고 다른 정규화도 조사했다. 정규화, 데이터 비율과 학습 길이를 함께 기록해야 사례 사이의 비교가 가능하다. 5.3절과 부록 D.
Claude 3.5 Haiku의 문자 수 표현
When Models Manipulate Manifolds의 HTML 보관본은 고정 폭으로 줄을 나눈 산문을 이어 쓰는 과제를 분석한다. 합성 평가 자료는 기존 줄바꿈을 제거한 뒤 단어 경계에 다시 줄바꿈을 넣으며, 15자부터 150자까지 5자 간격의 폭을 사용한다.
추적하는 값은 마지막 줄바꿈 이후의 문자 수다. 한 토큰에 여러 문자가 들어갈 수 있으므로 토큰 위치와 구별한다. 2.2절에서 문자 수별 평균 활성값은 6차원 PCA 부분공간 안의 휘어진 1차원 곡선으로 나타난다. 1차원은 카운트에 따라 곡선을 따라가는 자유도, 6차원은 그 곡선을 담아 분석하는 부분공간의 차원이다.
3.1절의 QK twist는 현재 문자 수와 이전 줄 너비의 표현을 Q와 K로 변환해, 일정한 차이에서 어텐션 점수가 크게 나오게 하는 구조다. 여러 경계 감지 헤드가 서로 다른 남은 거리에서 반응하고, 그 출력을 조합해 줄 끝까지의 공간을 표현한다.
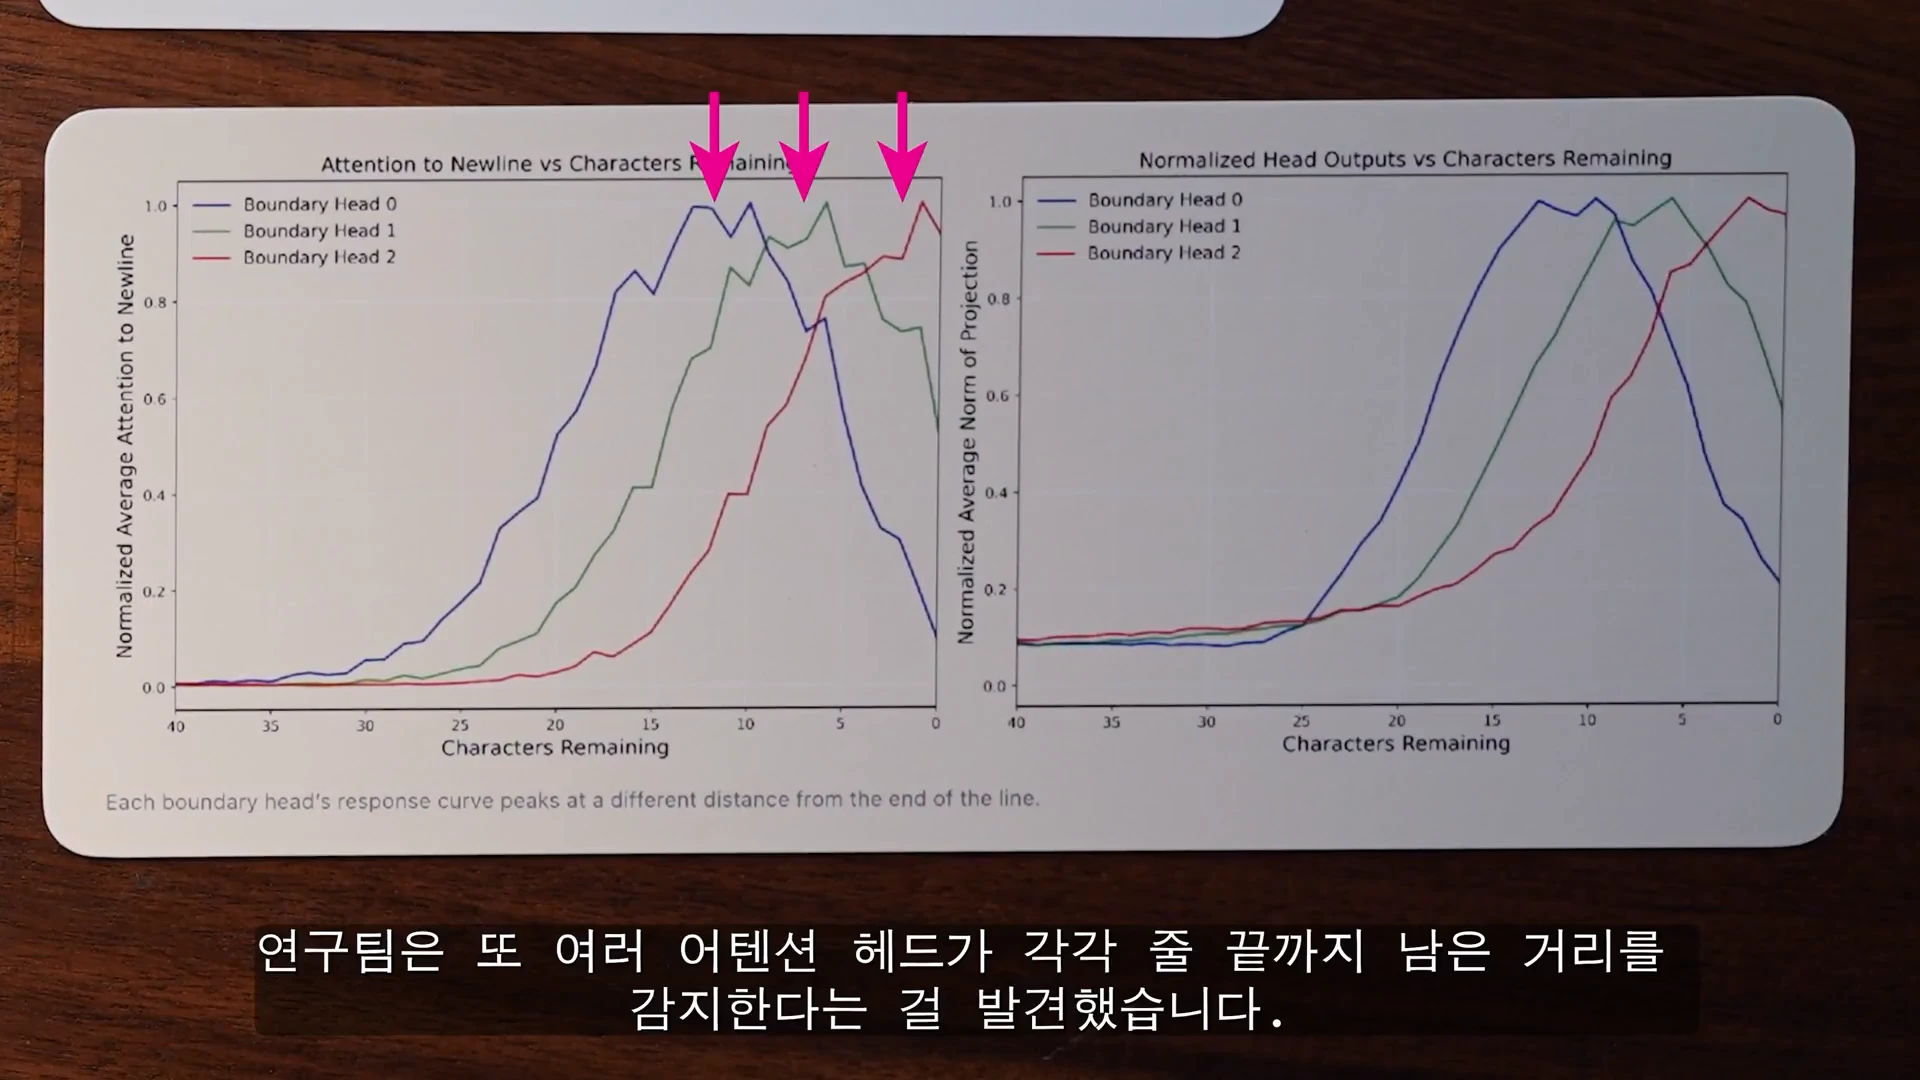
경계 감지 헤드별 반응 곡선. 가로축은 오른쪽으로 갈수록 남은 문자가 줄어듦. 원자료는 Anthropic 연구. 웰츠랩스, 30:28
영상의 ‘70자와 75자’는 특정 대응을 보여주는 예다. 원문 부록 K의 토큰당 평균 약 4.5자, 중앙값 4자는 토큰 길이 통계이므로 경계 헤드의 간격이나 모든 줄바꿈의 고정 기준으로 바꾸지 않는다.
기하 구조를 발견한 뒤 무엇을 검증했나
2.3절은 문자 수와 관련된 활성 부분공간을 제거하고, 무작위 방향 제거와 비교한다. 또 다른 문자 수의 평균 활성값으로 교체했을 때 줄바꿈 예측이 바뀌는지 살핀다. 3.2절에서는 남은 문자 수의 표현에도 제거와 교체 개입을 수행한다.
이 실험은 선택된 줄바꿈 과제에서 해당 표현의 인과적 기여를 뒷받침한다. 숫자를 읽어내는 프로브의 성능만으로 모델이 그 정보를 실제로 사용한다고 확정하는 것보다 강한 근거다. 모델 전체의 언어 능력이나 추론 능력을 설명할 때는 각 행동의 회로를 별도로 추적해야 한다.
이어서 볼 자료
Welch Labs Korea의 그로킹 영상은 원핫 입력, 파형과 고리, 삼각함수 조합, 제외 손실, 줄바꿈의 QK 변환을 시각적으로 연결한다. 영상 공개일은 2026-11-20이며 연구의 최초 발표일과 구분한다. 영상 제작 코드는 관련 애니메이션을 찾아보는 경로다.
어텐션의 기본 행렬 차원과 Q, K, V는 Attention Is All You Need 자료에서 확인할 수 있다. 이 문서의 핵심 질문은 그 구조 안에 학습으로 어떤 계산이 생겼는가다.
영상 후미가 인용하는 Andrej Karpathy의 Animals vs Ghosts(2025-10-01)는 인간 문서의 사전학습과 동물이 세계와 상호작용하며 배우는 방식의 차이를 논하는 관점 글이다. 그로킹이나 줄바꿈 회로의 실험 근거와 구분해 읽는다.
AI로 읽기 · Markdown
curl -fsSL 'https://www.readiz.com/llm-wiki/grokking-fourier-circuits-linebreak-manifolds/index.md'